El AS más grande no existe
Dos formas de ordenar una tabla BGP, ambas razonables, sin un solo miembro en común entre sus doce primeros
Michel Wijnberg
Toda vista de una tabla BGP acaba necesitando una lista. En la que medí hay 79.168 AS y en una pantalla caben quizá una docena, así que algo tiene que decidir qué docena.
Ese control parece trivial. Es lo más consecuente de toda la vista, porque la ordenación que elija no se limita a reordenar la respuesta. Cambia qué redes cree importantes el operador, y dos elecciones defendibles producen listas sin nada en común.
El eje obvio, y por qué falla
Ordenar por cuántos prefijos origina cada AS. El mayor primero. Es lo que hace casi todo
el mundo, es un GROUP BY, y está mal por dos motivos distintos.
No converge.
| Ordenado por número de prefijos originados | Cobertura de la tabla |
|---|---|
| Top 12 | 8,3 % |
| Top 1.000 | 52,9 % |
Mil redes para dar cuenta de media tabla. Eso no es una ordenación, es la tabla otra vez con las filas en otro orden. No hay una docena a la cabeza de este eje que explique nada, porque la distribución prácticamente no tiene cabeza.
Y premia la desagregación.
El número de prefijos mide anuncios, no espacio de direcciones, y ambos están solo vagamente relacionados. Lo dice un número: divida los prefijos anunciados de cada red entre la cantidad de bloques contiguos que realmente cubren y, para toda la tabla, este feed promedia 1,64 prefijos por bloque. Los doce primeros promedian 3,4. El caso más extremo medido, AS18403, anuncia 4.611 prefijos repartidos en 26 bloques, un factor de 177. AS9808 va a 86 veces, AS4538 a 66.
Así que la clasificación premia a quien trocea su espacio más fino. Una red que anuncia un /16 limpio cae por debajo de otra que anuncia ese mismo /16 como 256 /24, y la segunda es discutiblemente el peor ciudadano de internet. Ordenar por número de prefijos es ordenar por volumen de palabra.
Ordene la misma tabla por espacio de direcciones único (3.121.065.344 direcciones en total) y la lista no se baraja. Se descompone:
| AS | Puesto por prefijos | Puesto por espacio |
|---|---|---|
| AS16509 | 1 | 2 |
| AS9808 | 2 | 12 |
| AS8151 | 3 | 32 |
| AS12479 | 4 | 71 |
| AS7545 | 5 | 141 |
| AS39891 | 8 | 308 |
El octavo por anuncios es el 308 por espacio de direcciones. Mientras tanto, la red que realmente va primera en espacio, AS749, tiene el 7,17 % de ese total con 3.133 prefijos, y AS4134 llega tercera con 729. Son redes que anuncian bloques grandes enteros, que es lo que uno esperaría, y el número de prefijos las entierra.
Una trampa por el camino, porque equivocarse es fácil y silencioso: esto tiene que ser una unión, nunca una suma. Sumar 2^(32 − longitud de máscara) sobre prefijos que se solapan cuenta dos veces cada agregado que los cubre, medido en 1,269× para toda la tabla, y eso basta y sobra para cambiar el orden. Los prefijos hay que fusionarlos en rangos sin solape antes de ordenar o dibujar nada. Nosotros enviamos primero la versión que sumaba. No se cayó, los totales parecían razonables, y el orden que producía era lo bastante verosímil como para que nadie lo cuestionara hasta que una revisión fue a mirar. Ese es el modo de fallo que hay que temer en una medición: no una respuesta errónea que se delata, sino una creíble.
El eje que sí converge
Haga otra pregunta. No “quién anuncia más” sino “cuya desaparición me costaría más alcanzabilidad”. De forma voraz: elija el AS que alcanza más AS de origen, saque esos orígenes del conjunto y repita con lo que quede. Nuestros propios upstreams directamente conectados quedan excluidos, porque si no las primeras elecciones las domina el propio punto de observación en vez de algo relativo a la tabla.
| Paso | AS | Cuota acumulada de AS de origen alcanzados |
|---|---|---|
| 1 | AS2516 | 38 % |
| 2 | AS7575 | 60 % |
| 3 | AS2497 | 82 % |
| 4 | AS6939 | 90 % |
| 5 | AS1221 | 94 % |
Cinco redes alcanzan el 94 % de los AS de origen visibles desde este punto de observación. La misma tabla necesitaba mil para llegar al 53 % en el otro eje.
Esa es la respuesta que quiere un arquitecto: estas cinco son el sustrato de tránsito sobre el que descansa este punto de observación, y perder una de ellas es un tipo de suceso distinto de perder la red con más prefijos.
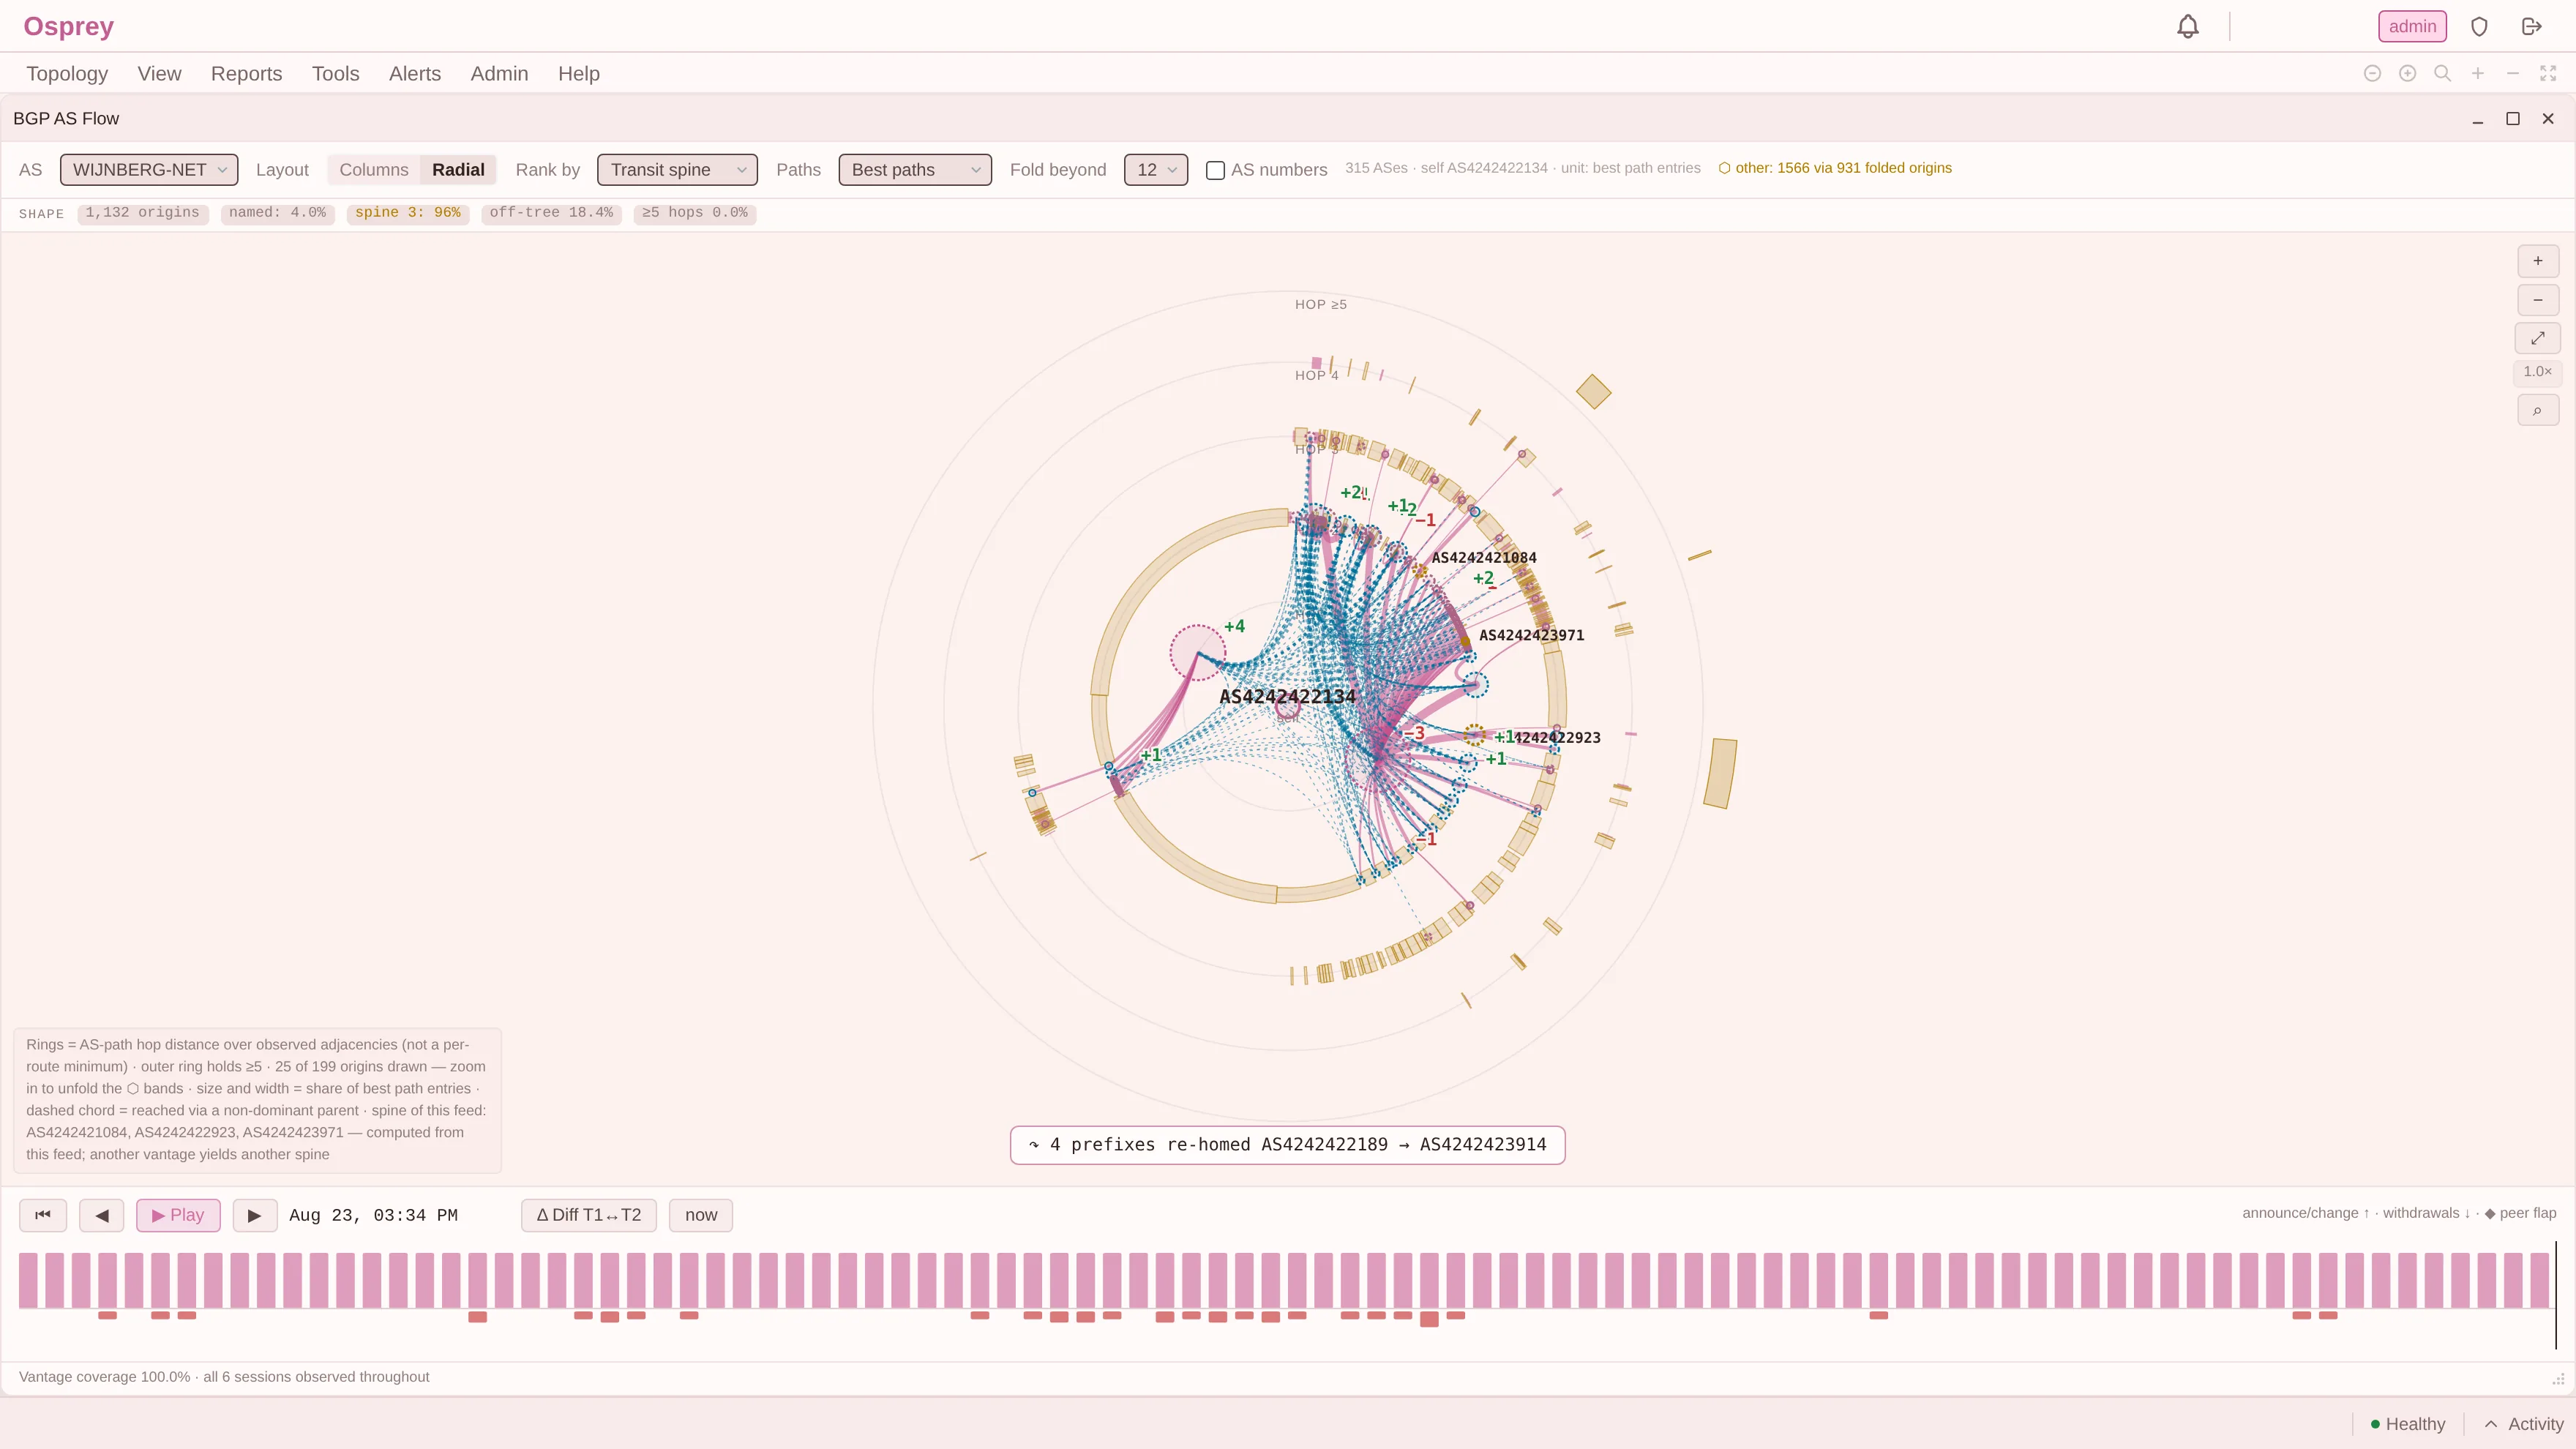
La imagen de arriba es el mismo control sobre un feed distinto y mucho más pequeño, donde la respuesta son tres redes al 96 % en lugar de cinco al 94 %. El número de entradas no es lo importante y no se traslada. Lo que sí se traslada es que este eje tiene cabeza, y que la franja enuncia su cobertura al lado en vez de dejarle preguntándose si las filas de la pantalla son casi toda la historia o una centésima parte de ella.
Necesita una advertencia, la que se ganó el artículo anterior. El alcance se calcula como un cono sobre el árbol dominante: cada AS se atribuye a su predecesor más pesado y se suma el subárbol que cuelga de él. Eso es una proyección en árbol de un grafo que acabo de dedicar un artículo a demostrar que no es un árbol, y el error no es hipotético, es el 17,5 % de masa de borde que no llega por el padre más pesado. Así que el número es una suma de árbol sobre algo que no lo es, y por eso el producto lo etiqueta como tal en vez de presentarlo como alcanzabilidad. Sirve para ordenar y no sirve para citarlo como garantía de dependencia.
Dos cosas me convencieron de que el número era sólido y no afortunado. Una muestra 1:10 del mismo colector, tomando uno de cada diez orígenes con todos sus prefijos, caminos y predecesores (11.136 AS, 7.854 orígenes, 106.900 prefijos), reproduce los mismos cinco AS en el mismo orden con 34/62/76/86/88 %. El mecanismo tampoco es misterioso, y es toda la diferencia entre los dos ejes. El número de prefijos pregunta qué posee cada red por su cuenta: cada prefijo pertenece a un origen, nada se comparte, así que la ordenación es una cola larga de aportaciones independientes. El alcance de tránsito pregunta qué depende de cada red, y las dependencias se solapan mucho. Cada elección absorbe casi todo lo que la siguiente podría haber reclamado, y por eso cinco entradas agotan la pregunta y mil entradas de número de prefijos no.
La parte que me hizo reescribir el control
Aquí está el hallazgo que no esperaba. Las dos listas de doce primeros, de la misma tabla, en la misma hora, comparten cero miembros.
No “casi distintas”. Ningún solapamiento.
Eso no es un problema de desempate, y no es algo que resuelva un buen valor por defecto. Significa que el control no es un orden de clasificación. Es un selector de pregunta, y las dos preguntas son:
- ¿Quién anuncia más prefijos? Respuesta: las redes de la tabla de desagregación de arriba.
- ¿Sobre qué se apoya esta tabla? Respuesta: un conjunto completamente distinto, ninguno de cuyos miembros aparece en la primera.
Las dos respuestas son correctas. Ninguna es “el AS más grande”. La expresión no se refiere a nada, y por eso una vista que ofrece una única ordenación y la llama importancia está afirmando algo que no puede sostener.
Así que el control en Osprey son dos ejes etiquetados explícitamente en vez de una dirección de orden, y el umbral que hay al lado dice qué papel está jugando: plegar más allá de N es una operación de disposición, nombrar los N primeros es una operación de etiquetado, y son dos cosas distintas hechas con el mismo número. Confundirlo fue uno de los hallazgos de revisión contra nuestra propia versión.
Lo que esto le cuesta al lector
Una ordenación que no converge tiene un modo de fallo concreto en un contexto de operación, y vale la pena nombrarlo porque no es obvio.
Si los doce primeros cubren el 8,3 %, entonces las doce filas de la pantalla no son representativas del otro 91,7 % de una manera que la pantalla no señala. Un operador que razone a partir de ellas razona a partir de una muestra seleccionada por una propiedad que nadie eligió deliberadamente. Parecen las redes importantes. Son las que anuncian en los trozos más pequeños.
El eje de alcance de tránsito tiene la propiedad contraria. Cinco filas cubriendo el 94 % significa que la pantalla le muestra casi toda la estructura, y lo que no ve es realmente marginal. Esa es la diferencia entre una lista y una explicación.
El límite
El alcance de tránsito se calcula desde su tabla, así que hereda todas las propiedades de su punto de observación. No es una medición de la estructura de internet. Es una medición de lo que su feed alcanza a ver de ella, y el siguiente artículo trata de cuánto distan esas dos cosas.
También depende de lo que sus upstreams decidieran enviarle. Un camino filtrado antes de llegarle no aparece en la clasificación, y ningún cálculo lo recupera. Los números de alcance son, por tanto, una cota inferior de la dependencia: todo lo listado es real, y puede haber estructura detrás del filtro que no lo esté.
Decirlo es barato, y es la diferencia entre un número con el que se puede planificar y un número que le dejará en evidencia.
La idea
El control que decide qué doce filas ve un operador no es un detalle de presentación. En esta tabla decide entre dos respuestas disjuntas, ambas defendibles, una de las cuales converge y la otra no.
“El AS más grande” suena a que nombra un hecho. Nombra la pregunta que el orden por defecto haya codificado, y casi ninguna herramienta le dice cuál fue.
Que es la regla de diseño de la que trata realmente este artículo: un control que decide qué mira un operador tiene que exponer la pregunta que responde. “Ordenar por: importancia” no es una comodidad. Es una elección de modelo, hecha por quien escribió el desplegable, en nombre de alguien a quien nunca le dirán que ocurrió.
Siguiente: esas cinco redes de tránsito son de Asia-Pacífico, y eso no es un hecho sobre internet. Su backbone no es el de internet.