Le plus grand AS n’existe pas
Deux façons de classer une table BGP, toutes deux raisonnables, sans un seul membre commun dans leurs douze premiers
Michel Wijnberg
Toute vue d’une table BGP finit par avoir besoin d’une liste. Celle que j’ai mesurée contient 79 168 AS et un écran en accueille peut-être une douzaine : quelque chose doit donc décider laquelle.
Ce réglage a l’air anodin. C’est le plus lourd de conséquences de toute la vue, car le classement retenu ne se contente pas de réordonner la réponse. Il change quels réseaux l’exploitant croit importants, et deux choix défendables produisent des listes sans rien en commun.
L’axe évident, et pourquoi il échoue
Classer selon le nombre de préfixes que chaque AS origine. Le plus gros d’abord. C’est ce
que fait presque tout le monde, c’est un GROUP BY, et c’est faux de deux façons
distinctes.
Il ne converge pas.
| Classé par nombre de préfixes originés | Couverture de la table |
|---|---|
| Top 12 | 8,3 % |
| Top 1 000 | 52,9 % |
Mille réseaux pour rendre compte de la moitié de la table. Ce n’est pas un classement, c’est la table à nouveau avec les lignes dans un autre ordre. Il n’y a en tête de cet axe aucune douzaine qui explique quoi que ce soit, parce que la distribution n’a pour ainsi dire pas de tête.
Et il récompense la désagrégation.
Le nombre de préfixes mesure des annonces, pas de l’espace d’adressage, et les deux ne sont que faiblement liés. Un chiffre le dit : divisez les préfixes annoncés de chaque réseau par le nombre de blocs contigus qu’ils couvrent réellement et, sur l’ensemble de la table, ce flux affiche 1,64 préfixe par bloc. Les douze premiers sont à 3,4 en moyenne. Le cas le plus extrême mesuré, AS18403, annonce 4 611 préfixes répartis sur 26 blocs, soit un facteur 177. AS9808 est à 86 fois, AS4538 à 66.
Le palmarès récompense donc celui qui découpe son espace le plus finement. Un réseau qui annonce un /16 propre passe derrière un réseau qui annonce ce même /16 en 256 /24, et le second est sans doute le moins bon citoyen d’internet. Trier par nombre de préfixes, c’est trier par volume de parole.
Classez la même table par espace d’adressage unique (3 121 065 344 adresses au total) et la liste ne se réordonne pas. Elle se disloque :
| AS | Rang par préfixes | Rang par espace |
|---|---|---|
| AS16509 | 1 | 2 |
| AS9808 | 2 | 12 |
| AS8151 | 3 | 32 |
| AS12479 | 4 | 71 |
| AS7545 | 5 | 141 |
| AS39891 | 8 | 308 |
Le huitième par annonces est le 308e par espace d’adressage. Pendant ce temps, le réseau réellement premier sur l’espace, AS749, détient 7,17 % de ce total avec 3 133 préfixes, et AS4134 arrive troisième avec 729. Ce sont des réseaux qui annoncent de gros blocs d’un seul tenant, ce que l’on espérerait, et le nombre de préfixes les enterre.
Un piège en chemin, car s’y tromper est facile et silencieux : il faut une union, jamais une somme. Additionner 2^(32 − longueur de masque) sur des préfixes qui se recouvrent compte deux fois chaque agrégat couvrant, mesuré à 1,269× sur toute la table, et cela suffit largement à changer l’ordre. Les préfixes doivent être fusionnés en plages disjointes avant tout classement ou tout dessin. Nous avons d’abord livré la version qui somme. Elle n’a pas planté, les totaux avaient l’air raisonnables, et l’ordre produit était assez plausible pour que personne ne le remette en cause avant qu’une revue n’aille voir. C’est le mode de défaillance à craindre dans une mesure : non pas une réponse fausse qui s’annonce, mais une réponse crédible.
L’axe qui converge
Posez une autre question. Non pas « qui annonce le plus » mais « dont la disparition me coûterait le plus d’accessibilité ». De façon gloutonne : prenez l’AS qui atteint le plus d’AS d’origine, retirez ces origines du lot, recommencez sur ce qui reste. Nos propres transitaires directement connectés sont exclus, sans quoi les premiers choix sont dominés par le point de vue lui-même plutôt que par quoi que ce soit de la table.
| Étape | AS | Part cumulée des AS d’origine atteints |
|---|---|---|
| 1 | AS2516 | 38 % |
| 2 | AS7575 | 60 % |
| 3 | AS2497 | 82 % |
| 4 | AS6939 | 90 % |
| 5 | AS1221 | 94 % |
Cinq réseaux atteignent 94 % des AS d’origine visibles depuis ce point de vue. La même table en demandait mille pour atteindre 53 % sur l’autre axe.
C’est la réponse que veut un architecte : ces cinq-là sont le substrat de transit sur lequel repose ce point de vue, et en perdre un relève d’une autre catégorie d’événement que perdre le réseau ayant le plus de préfixes.
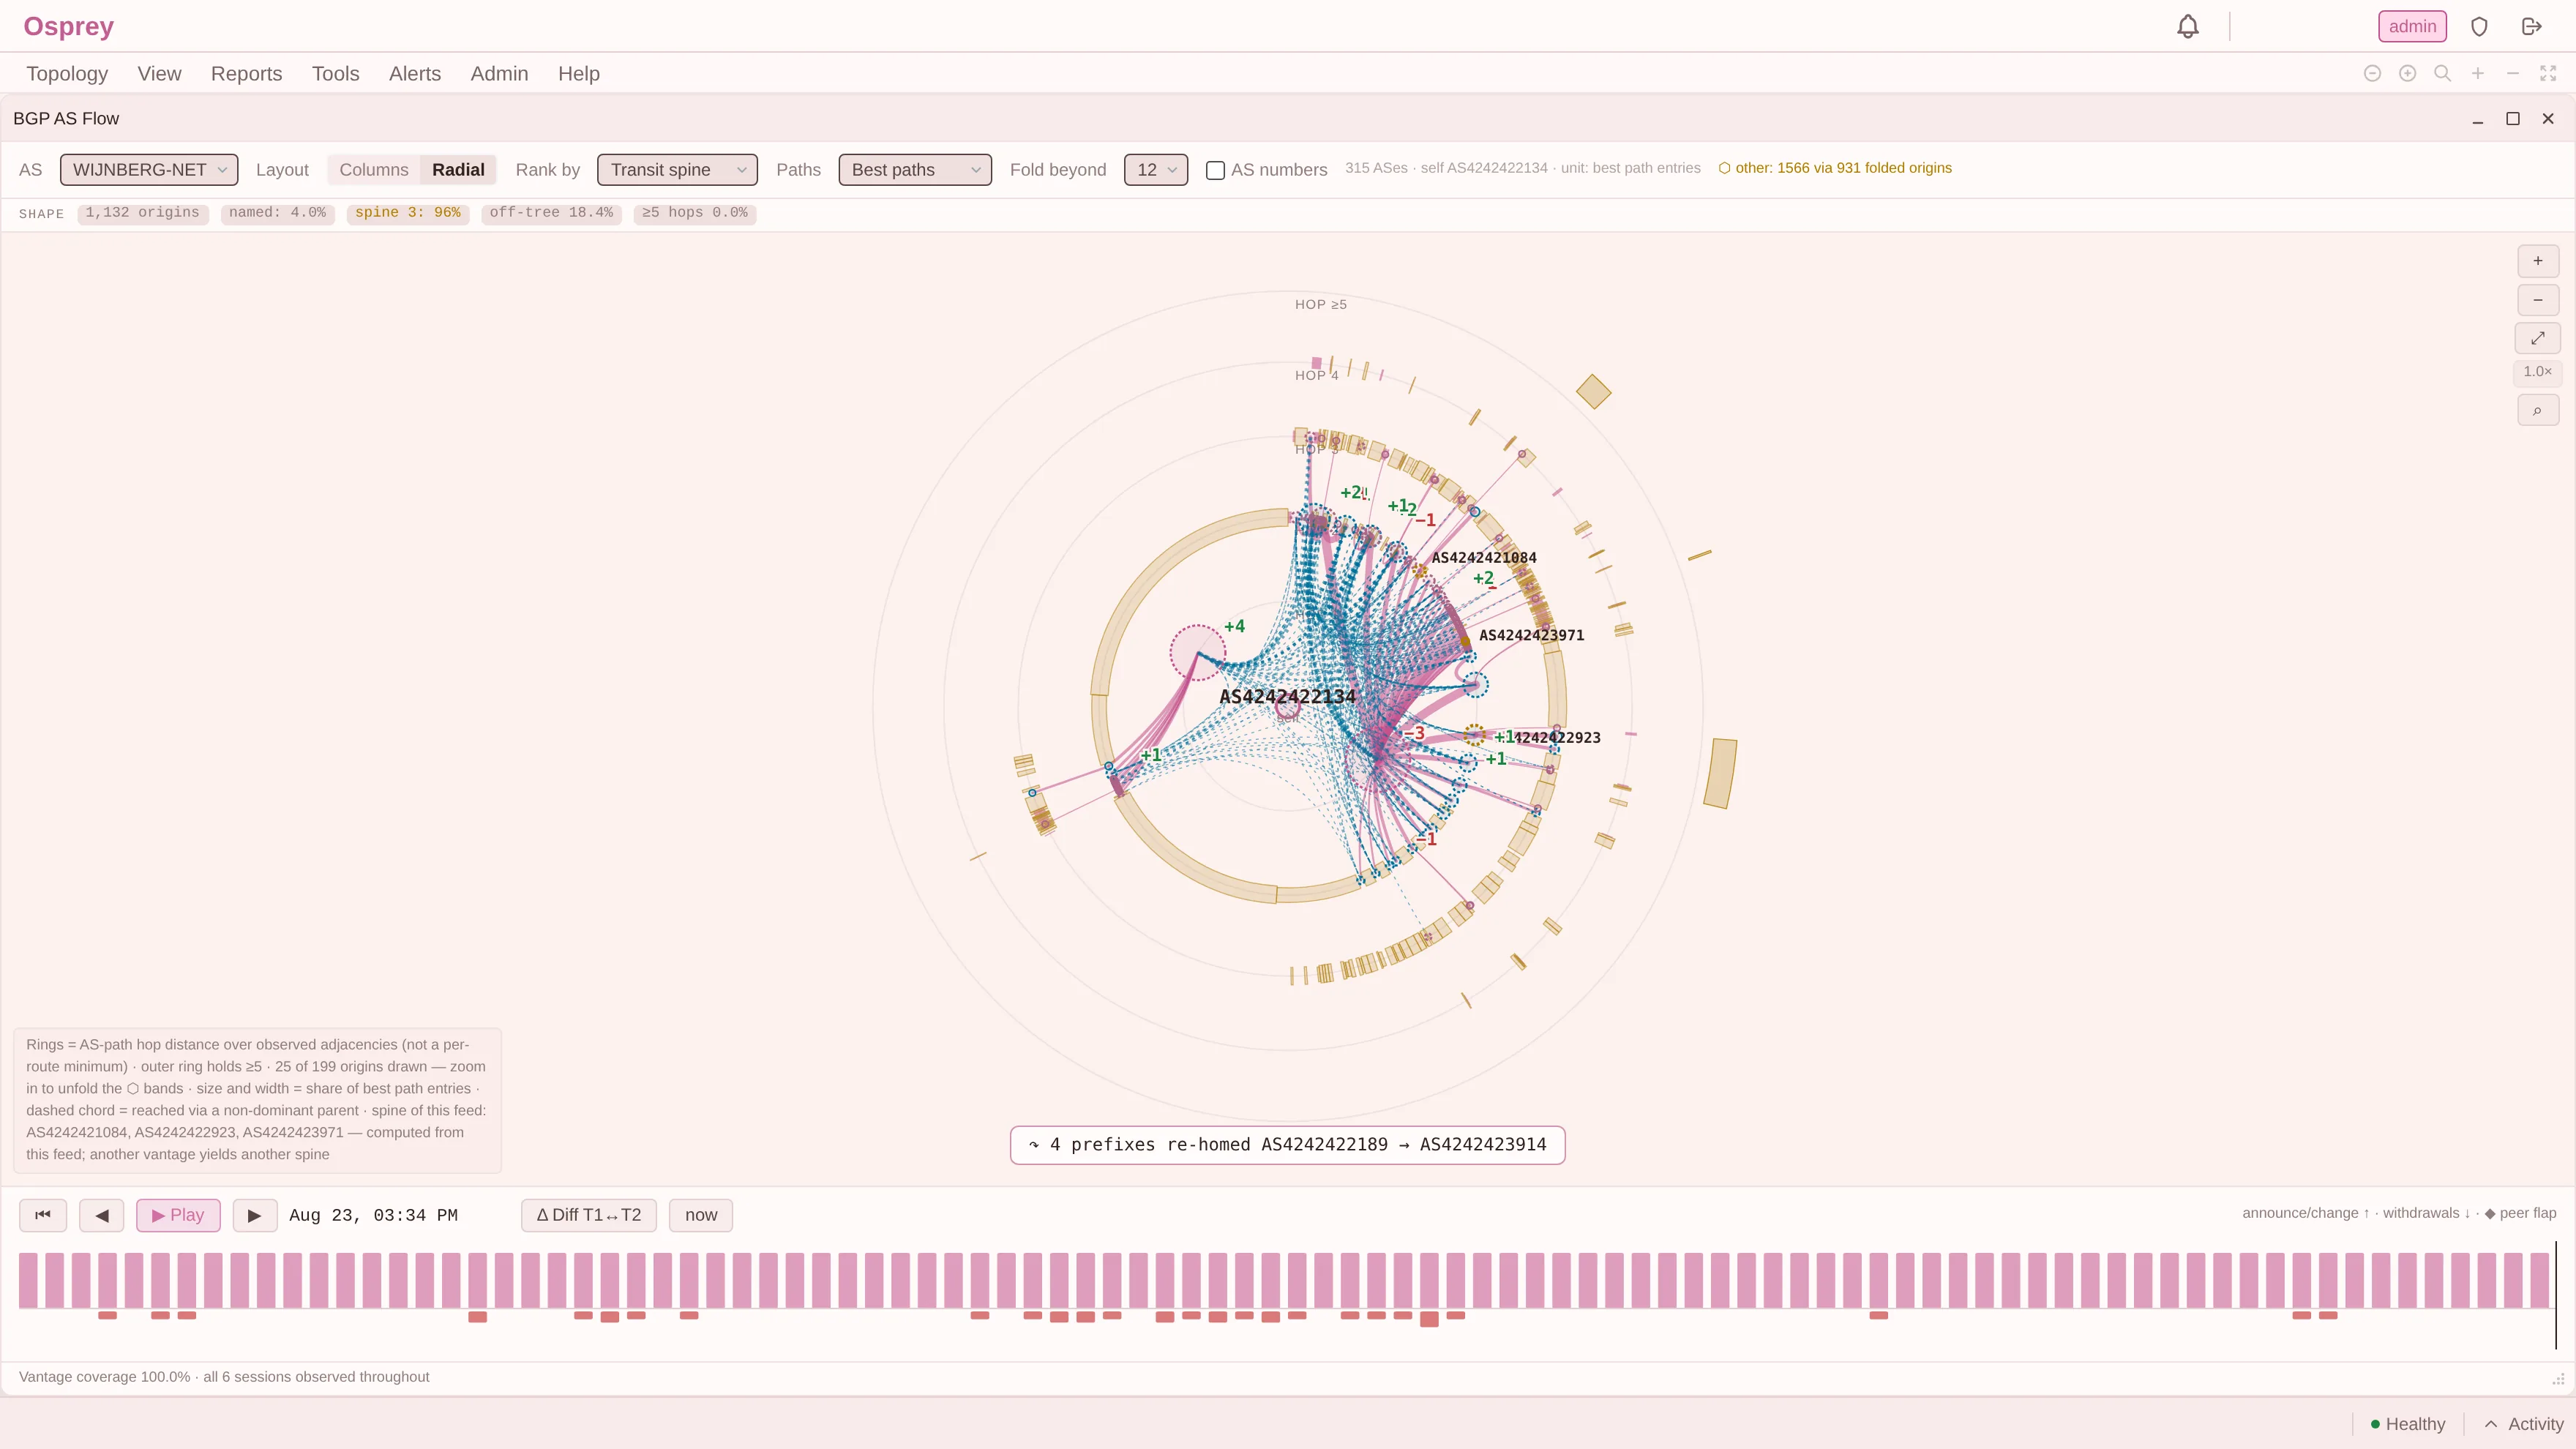
L’image ci-dessus est le même réglage sur un flux différent et bien plus petit, où la réponse tient en trois réseaux à 96 % plutôt qu’en cinq à 94 %. Le nombre d’entrées n’est pas la question et ne se transpose pas. Ce qui se transpose, c’est que cet axe a une tête, et que le bandeau énonce sa couverture juste à côté au lieu de vous laisser deviner si les lignes à l’écran sont l’essentiel de l’histoire ou un centième de celle-ci.
Une réserve s’impose, celle que l’article précédent a méritée. La portée est calculée comme un cône sur l’arbre dominant : chaque AS est rattaché à son prédécesseur le plus lourd, et le sous-arbre en dessous est sommé. C’est une projection en arbre d’un graphe dont je viens de passer un article à montrer qu’il n’en est pas un, et l’erreur n’est pas hypothétique : ce sont les 17,5 % de masse de bordure qui n’arrivent pas par le parent le plus lourd. Le chiffre est donc une somme d’arbre sur un non-arbre, ce pour quoi le produit l’étiquette comme telle plutôt que de la présenter comme de l’accessibilité. C’est assez bon pour classer et pas assez pour être cité comme garantie de dépendance.
Deux choses m’ont convaincu que le chiffre était solide et non chanceux. Un échantillon 1:10 du même collecteur, une origine sur dix reprise avec tous ses préfixes, chemins et prédécesseurs (11 136 AS, 7 854 origines, 106 900 préfixes), reproduit les mêmes cinq AS dans le même ordre à 34/62/76/86/88 %. Le mécanisme n’a rien de mystérieux non plus, et c’est toute la différence entre les deux axes. Le nombre de préfixes demande ce que chaque réseau possède en propre : chaque préfixe appartient à une origine, rien n’est partagé, donc le classement est une longue traîne de contributions indépendantes. La portée de transit demande ce qui dépend de chaque réseau, et les dépendances se recouvrent beaucoup. Chaque choix absorbe l’essentiel de ce que le suivant aurait pu revendiquer, ce pour quoi cinq entrées épuisent la question là où mille entrées de comptage de préfixes n’y parviennent pas.
Le passage qui m’a fait réécrire le réglage
Voici le constat auquel je ne m’attendais pas. Les deux listes de douze premiers, issues de la même table, à la même heure, partagent zéro membre.
Pas « largement différentes ». Aucun recouvrement.
Ce n’est pas un problème de départage, et ce n’est pas quelque chose qu’une bonne valeur par défaut règle. Cela signifie que le réglage n’est pas un ordre de tri. C’est un sélecteur de question, et les deux questions sont :
- Qui annonce le plus de préfixes ? Réponse : les réseaux du tableau de désagrégation ci-dessus.
- Sur quoi cette table repose-t-elle ? Réponse : un ensemble complètement différent, dont aucun membre n’apparaît dans le premier.
Les deux réponses sont justes. Aucune n’est « le plus grand AS ». L’expression ne renvoie à rien, ce pour quoi une vue qui propose un classement unique et l’appelle importance affirme quelque chose qu’elle ne peut pas étayer.
Le réglage dans Osprey est donc deux axes explicitement étiquetés plutôt qu’une direction de tri, et le seuil à côté dit quel rôle il joue : replier au-delà de N est une opération de mise en page, nommer les N premiers est une opération d’étiquetage, et ce sont deux choses différentes faites au même nombre. S’y tromper faisait partie des constats de revue contre notre propre version.
Ce que cela coûte au lecteur
Un classement qui ne converge pas a un mode de défaillance précis en exploitation, et il vaut la peine de le nommer parce qu’il n’est pas évident.
Si les douze premiers couvrent 8,3 %, alors les douze lignes à l’écran ne sont pas représentatives des 91,7 % restants, d’une manière que l’écran ne signale pas. Un exploitant qui raisonne à partir d’elles raisonne à partir d’un échantillon sélectionné par une propriété que personne n’a choisie délibérément. Cela ressemble aux réseaux importants. Ce sont ceux qui annoncent par les plus petits morceaux.
L’axe de portée de transit a la propriété inverse. Cinq lignes couvrant 94 % signifient que l’écran vous montre presque toute la structure, et que ce que vous ne voyez pas est réellement marginal. C’est la différence entre une liste et une explication.
La limite
La portée de transit est calculée à partir de votre table, elle hérite donc de toutes les propriétés de votre point de vue. Ce n’est pas une mesure de la structure d’internet. C’est une mesure de ce que votre flux en perçoit, et l’article suivant traite de la distance entre ces deux choses.
Elle dépend aussi de ce que vos transitaires ont choisi de vous envoyer. Un chemin filtré avant de vous parvenir n’apparaît pas dans le classement, et aucun calcul ne le récupère. Les chiffres de portée sont donc une borne inférieure de la dépendance : tout ce qui est listé est réel, et il peut exister derrière le filtre une structure qui ne l’est pas.
Le dire ne coûte rien, et c’est la différence entre un chiffre avec lequel on planifie et un chiffre qui vous mettra dans l’embarras.
L’essentiel
Le réglage qui décide quelles douze lignes un exploitant voit n’est pas un détail de présentation. Sur cette table, il tranche entre deux réponses disjointes, toutes deux défendables, dont l’une converge et l’autre non.
« Le plus grand AS » semble nommer un fait. Il nomme la question que le tri par défaut a encodée, et presque aucun outil ne vous dit laquelle c’était.
C’est la règle de conception dont parle vraiment cet article : un réglage qui décide de ce qu’un exploitant regarde doit exposer la question auquel il répond. « Trier par : importance » n’est pas une commodité. C’est un choix de modèle, fait par celui qui a écrit le menu déroulant, au nom de quelqu’un à qui on ne dira jamais qu’il a eu lieu.
Ensuite : ces cinq réseaux de transit sont en Asie-Pacifique, et ce n’est pas un fait sur internet. Votre cœur de réseau n’est pas celui d’internet.