最大的 AS 并不存在
给一张 BGP 表排序有两种办法,都说得通,而它们的前十二名毫无交集
Michel Wijnberg
任何一种 BGP 表视图,最终都需要一份列表。我测的那张表里有 79,168 个 AS,而一块屏幕大概只放得下 十来个,所以总得有什么东西来决定是哪十来个。
那个控件看上去无足轻重。它其实是整个视图里后果最重的一处,因为你选定的排序不只是把答案重新排列 一遍。它会改变运营者认为哪些网络重要,而两种都站得住脚的选择,会产出毫无交集的两份列表。
显而易见的那根轴,以及它为何失败
按每个 AS 起源的前缀数量排序。多的在前。几乎所有工具都这么做,一个 GROUP BY 就够了,而它在
两个彼此独立的层面上都是错的。
它不收敛。
| 按起源前缀数排序 | 对整张表的覆盖 |
|---|---|
| 前 12 | 8.3% |
| 前 1,000 | 52.9% |
一千个网络才交代得了半张表。这不是排名,这只是把行换了个顺序的同一张表。这根轴的前端没有哪 十来个能解释任何事情,因为这个分布几乎没有头部可言。
而且它奖励拆分广告。
前缀数量衡量的是广告,不是地址空间,两者只是松散相关。一个数字就能说明:把每个网络广告的前缀数 除以它们实际覆盖的连续地址块数,就整张表而言,这条馈送平均为每块 1.64 个前缀。前十二名平均 是 3.4。测得最极端的例子 AS18403,用 26 个块广告了 4,611 个前缀,倍率高达 177。 AS9808 是 86 倍,AS4538 是 66 倍。
于是这份榜单奖励的是把自己空间剁得最细的一方。一个干干净净广告一个 /16 的网络,会沉到把同一个 /16 拆成 256 个 /24 来广告的网络之下,而后者可以说才是更差的互联网公民。按前缀数排序,就是按 说话量排序。
改用去重后的地址空间给同一张表排序(总计 3,121,065,344 个地址),列表不是被打乱,而是 散架:
| AS | 按前缀排名 | 按地址空间排名 |
|---|---|---|
| AS16509 | 1 | 2 |
| AS9808 | 2 | 12 |
| AS8151 | 3 | 32 |
| AS12479 | 4 | 71 |
| AS7545 | 5 | 141 |
| AS39891 | 8 | 308 |
按广告数排第八的,按地址空间排第 308。与此同时,在空间上真正排第一的 AS749,用 3,133 个前缀 握有该总量的 7.17%,AS4134 则以 729 个位列第三。这些网络整块整块地广告大地址块,正是人们 希望看到的样子,而前缀数把它们埋了。
路上还有一个陷阱,因为踩中它既容易又无声:这必须是并集,绝不能是求和。在互相重叠的 前缀上累加 2^(32 − 掩码长度),会把每一个覆盖性聚合都重复计入,整张表上实测为 1.269 倍, 这已经绰绰有余地改变了顺序。必须先把前缀合并成互不重叠的区间,然后才谈排序或绘制。我们最初 发布的正是求和版本。它没有崩溃,总数看着合理,产出的顺序也足够可信,直到一次评审去查才有人 质疑。这才是做测量时该害怕的失效方式:不是会自报家门的错误答案,而是一个可信的答案。
真正收敛的那根轴
换一个问题。不是”谁广告得最多”,而是”谁消失了会让我损失最多可达性”。用贪心法:挑出触达最多起源 AS 的那个 AS,把这些起源从池子里拿掉,再对剩下的重复一次。我们自己直连的上游要排除掉,否则 最前面几个选择会被观测点本身主导,而不是被表本身的性质主导。
| 步骤 | AS | 累计触达的起源 AS 份额 |
|---|---|---|
| 1 | AS2516 | 38% |
| 2 | AS7575 | 60% |
| 3 | AS2497 | 82% |
| 4 | AS6939 | 90% |
| 5 | AS1221 | 94% |
五个网络就触达了从这个观测点可见的起源 AS 的 94%。 同一张表,另一根轴上要一千个才到 53%。
这才是架构师想要的答案:这五个就是这个观测点所依托的中转基底,失去其中之一,与失去前缀最多的 那个网络,是完全不同量级的事件。
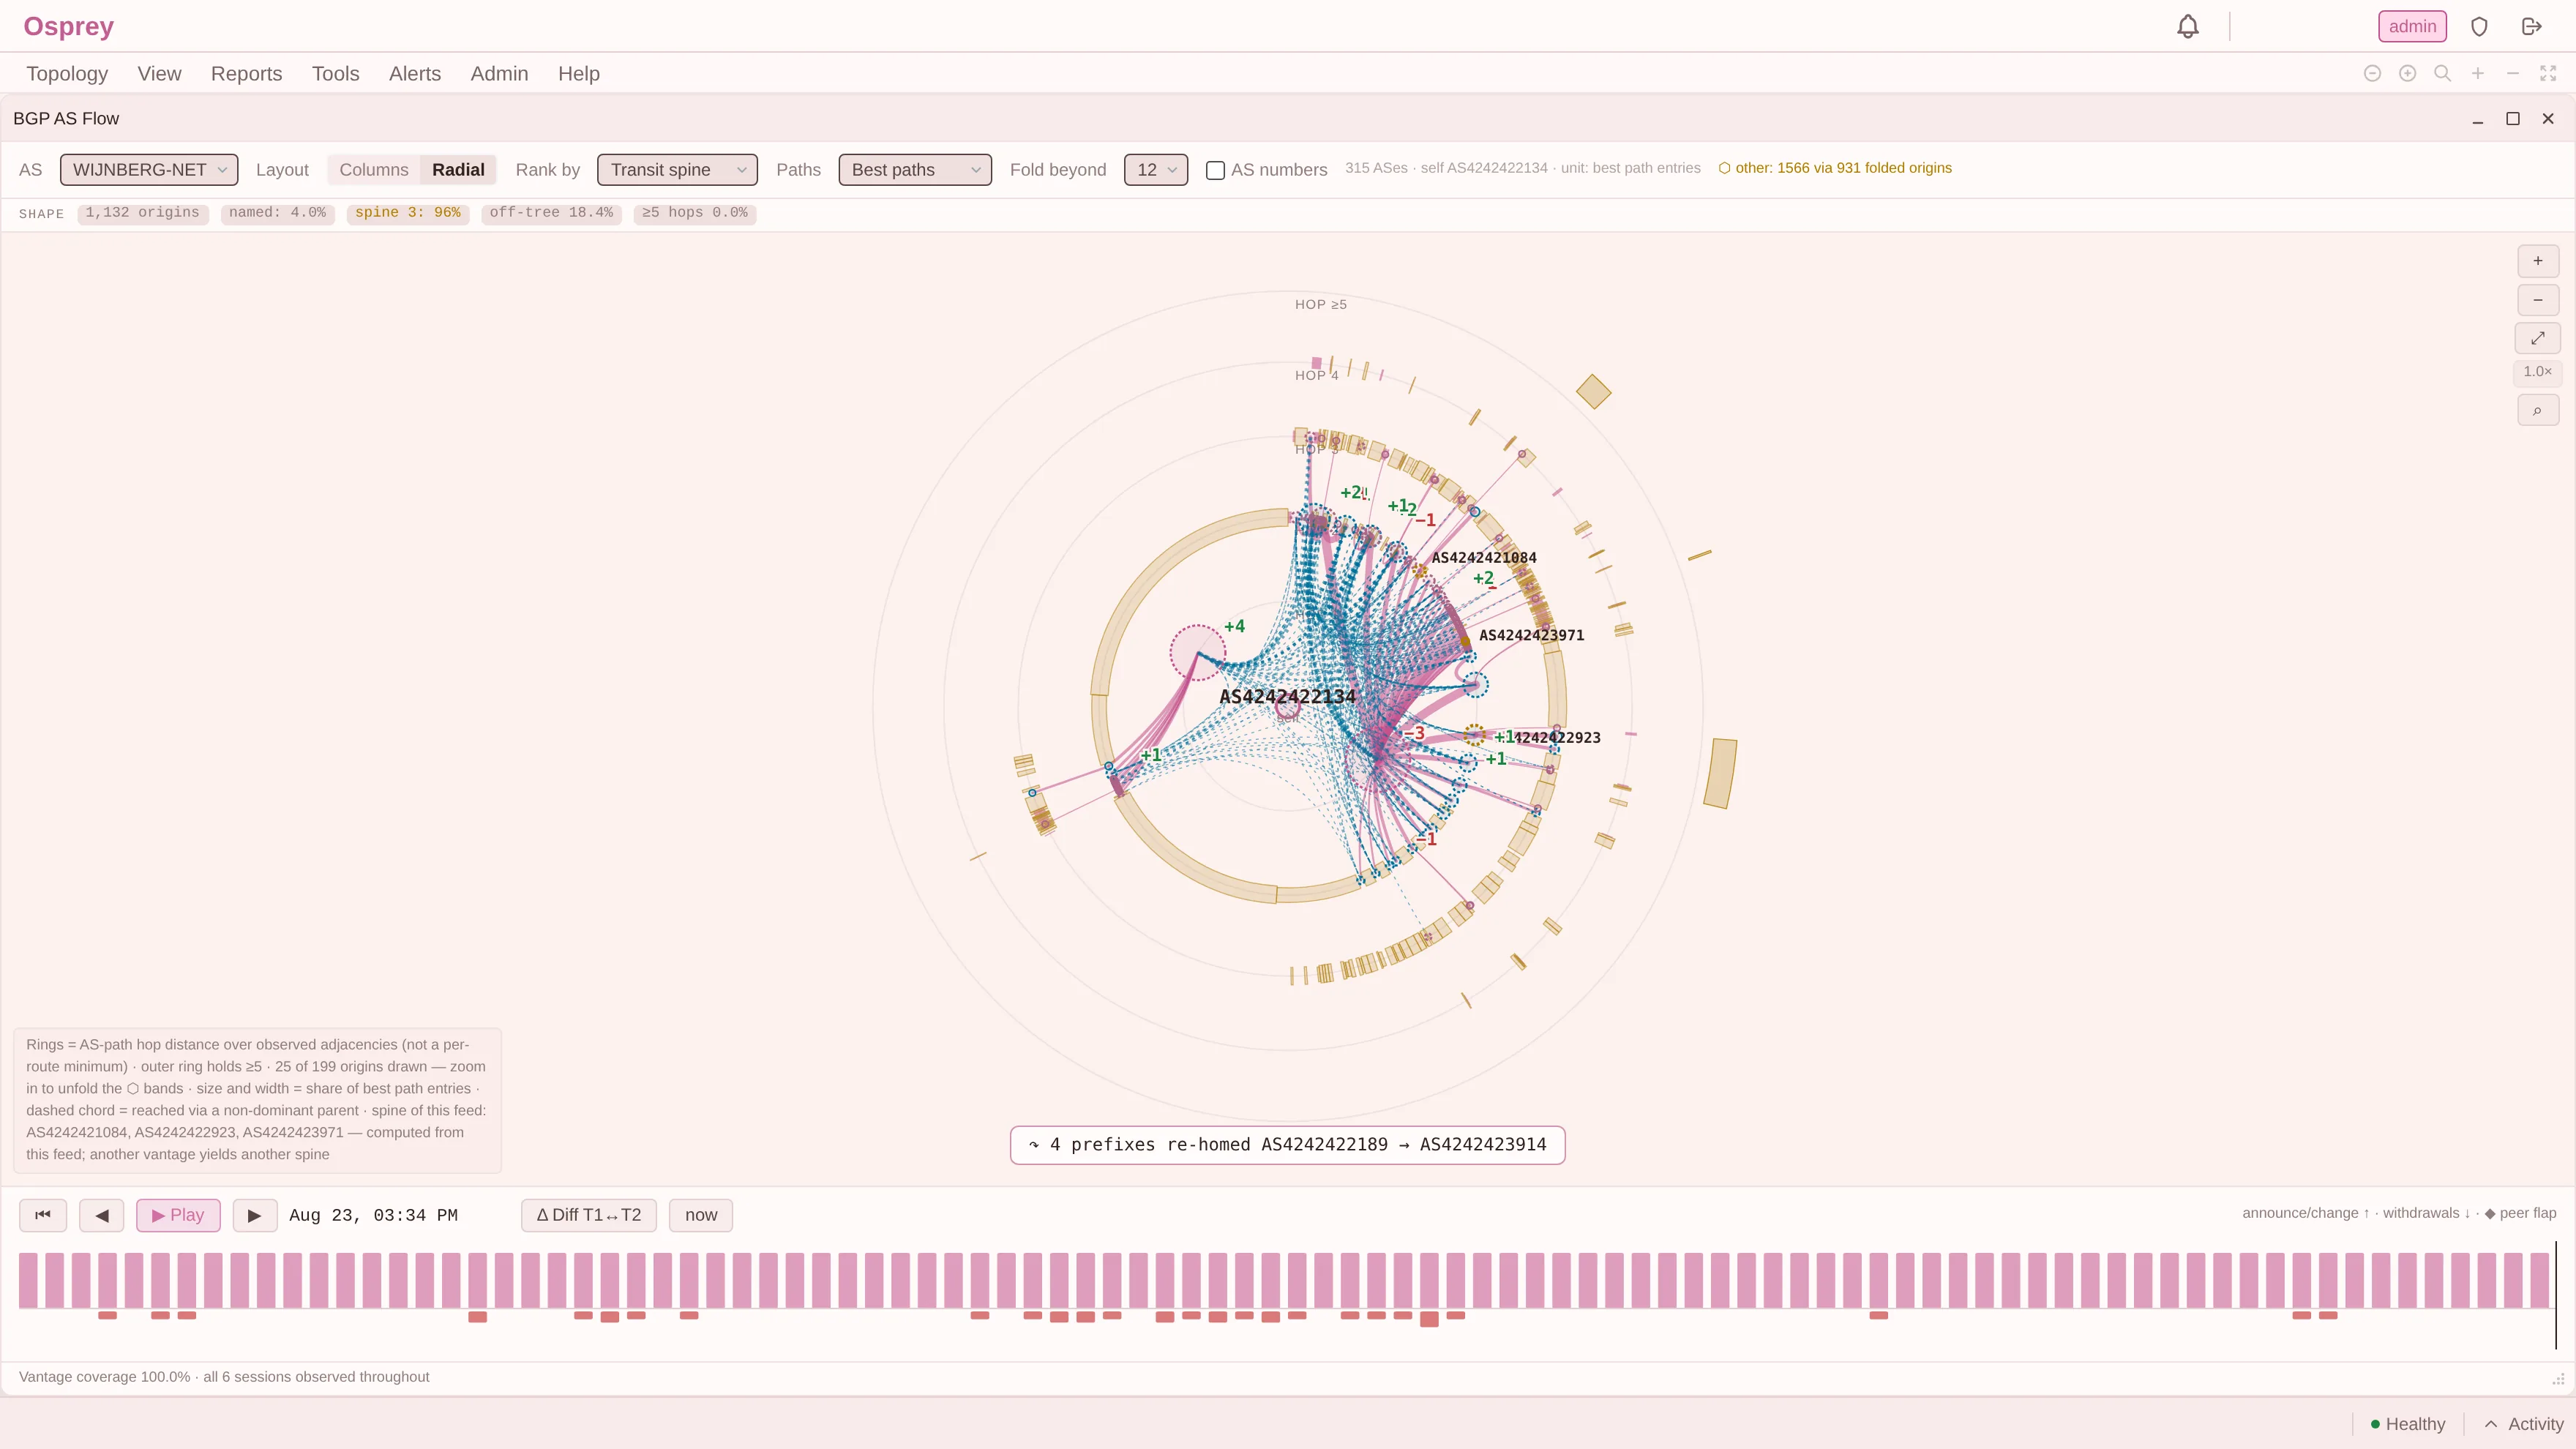
上面这幅图是同一个控件在另一条、而且小得多的馈送上的样子,那里的答案是三个网络覆盖 96%,而不是 五个覆盖 94%。条目的数量并不是重点,也无法迁移。能迁移的是:这根轴根本上是有头部的;以及条带把 它的覆盖率就写在旁边,而不是让你去猜屏幕上这几行究竟是故事的大部分,还是它的百分之一。
它需要一条限定,正是上一篇挣来的那条。触达范围是作为 支配树上的锥来计算的:每个 AS 归属到它最重的前驱,再把其下的子树求和。而这是对一张我刚用 整整一篇文章证明其并非树的图所做的树投影,误差也不是假设出来的,它就是那 17.5% 并非经由最重 父节点到达的边缘质量。所以这个数是非树之上的树求和,因此产品也如实这样标注它,而不是把它当作 可达性来呈现。它够用来排序,不够拿来当依赖性保证引用。
有两点让我相信这个数字是稳的而不是运气。同一采集器的 1:10 抽样,每十个起源取一个并连同其全部 前缀、路径与前驱一起带过来(11,136 个 AS、7,854 个起源、106,900 个前缀),以同样的顺序重现了 同样的五个 AS,比例为 34/62/76/86/88%。 其机理也不神秘,而这正是两根轴的全部差别所在。前缀数问的是每个网络自己独有什么:每个前缀只属于 一个起源,没有任何共享,所以排名是一条由独立贡献构成的长尾。中转触达问的是有什么依赖于每个网络, 而依赖关系高度重叠。每一次挑选都吸收掉了下一次本可以主张的大部分,因此五项就把问题穷尽了,而 一千项前缀数却做不到。
让我重写这个控件的那部分
下面是我没有预料到的发现。同一张表、同一个小时里做出的两份前十二名列表,共同成员为零。
不是”大体不同”。是完全没有交集。
这不是一个平局裁决问题,也不是一个好的默认值能解决的事。它意味着这个控件根本不是排序方式。 它是一个问题选择器,而那两个问题是:
- 谁广告的前缀最多? 答案:上面那张拆分广告表里的网络。
- 这张表究竟依托在什么之上? 答案:一个完全不同的集合,其中没有一个出现在第一份列表里。
两个答案都对。哪个都不是”最大的 AS”。这个说法并不指向任何东西,所以任何提供单一排名并称之为 重要性的视图,都在做出它无法支撑的断言。
因此 Osprey 里的这个控件是两根被明确标注的轴,而不是一个排序方向;旁边的阈值则说明它此刻扮演 的角色:超过 N 就折叠是布局操作,给前 N 命名是标注操作,是对同一个数字做的两件不同的事。 把这两者搞混,正是针对我们自己版本的评审发现之一。
这让读者付出什么代价
一个不收敛的排名,在运维语境下有一种特定的失效方式,值得点名,因为它并不明显。
如果前十二只覆盖 8.3%,那么屏幕上的十二行对其余 91.7% 就是不具代表性的,而屏幕并不会提示这 一点。据此推理的运营者,是在从一个由无人刻意选择的性质所筛出的样本里推理。它看起来像是重要的 网络。它其实是广告切得最碎的那些网络。
中转触达这根轴的性质正相反。五行覆盖 94%,意味着屏幕展示的几乎就是全部结构,而你看不见的那些 确实无关紧要。这就是一份列表和一个解释之间的差别。
边界
中转触达是从你的表算出来的,因此继承了你的观测点的每一项性质。它不是对互联网结构的测量。 它是对你的馈送能看见多少互联网结构的测量,而这两者相距多远,正是下一篇的主题。
它还取决于你的上游选择发送什么。一条在抵达你之前就被过滤掉的路径,不会出现在排名里,任何计算 都找不回来。因此触达数字是依赖性的下界:列出的一切都真实存在,而过滤之外可能还存在没被列出的 结构。
把这句话说出来是免费的,而这正是一个能用来做规划的数字与一个会让你难堪的数字之间的差别。
要点
决定运营者看到哪十二行的那个控件,不是一个呈现细节。在这张表上,它是在两个互不相交、都站得住脚 的答案之间做选择,其中一个收敛,另一个不收敛。
“最大的 AS”听起来像是在指称一个事实。它指称的其实是默认排序恰好编码进去的那个问题,而绝大多数 工具从不告诉你那是哪一个。
而这正是本文真正要讲的设计准则:一个决定运营者看什么的控件,必须把它所回答的问题摊开来。 “排序方式:重要性”不是便利。它是一次模型选择,由写下拉菜单的那个人做出,代替一个永远不会被 告知此事发生过的人做出。
下一篇:那五个中转网络位于亚太,而这并不是关于互联网的事实。 你的骨干不是互联网的骨干。