가장 큰 AS는 존재하지 않는다
BGP 테이블을 줄 세우는 두 가지 방법, 둘 다 합리적이지만 상위 열둘에 겹치는 이름이 하나도 없다
Michel Wijnberg
BGP 테이블을 보는 어떤 뷰든 결국은 목록이 필요합니다. 제가 측정한 테이블에는 AS가 79,168개 있고 화면에는 열두어 개가 들어가니, 무언가가 어느 열두 개인지를 정해야 합니다.
그 컨트롤은 사소해 보입니다. 뷰 전체에서 가장 결과가 큰 요소입니다. 어떤 순위를 고르느냐가 답을 재배열하는 데 그치지 않기 때문입니다. 그것은 운영자가 어떤 네트워크를 중요하다고 믿을지를 바꾸고, 방어 가능한 두 선택이 공통분모가 전혀 없는 목록을 만들어 냅니다.
뻔한 축, 그리고 그것이 실패하는 이유
각 AS가 기점으로 내는 프리픽스 수로 줄 세우기. 많은 순으로. 거의 모든 도구가 그렇게 하고,
GROUP BY 하나면 되고, 서로 다른 두 가지 방식으로 틀렸습니다.
수렴하지 않습니다.
| 기점 프리픽스 수 기준 순위 | 테이블 커버리지 |
|---|---|
| 상위 12 | 8.3% |
| 상위 1,000 | 52.9% |
테이블 절반을 설명하는 데 네트워크 천 개. 그건 순위가 아니라 행 순서만 바꾼 테이블 그 자체입니다. 이 축의 맨 앞에는 무언가를 설명해 주는 열두 개가 없습니다. 분포에 머리라고 할 것이 사실상 없기 때문입니다.
게다가 분할 광고에 상을 줍니다.
프리픽스 수가 재는 것은 광고이지 주소 공간이 아니며, 둘의 관계는 느슨할 뿐입니다. 숫자 하나가 그것을 말해 줍니다. 각 네트워크가 광고한 프리픽스 수를 그것이 실제로 덮는 연속 주소 블록 수로 나누면, 이 피드는 테이블 전체 평균 블록당 1.64 프리픽스입니다. 상위 열둘의 평균은 3.4. 측정된 가장 극단적인 사례인 AS18403은 26개 블록에 걸쳐 4,611개 프리픽스, 무려 177배입니다. AS9808은 86배, AS4538은 66배.
즉 이 순위표는 자기 공간을 가장 잘게 썬 쪽에 상을 줍니다. 깔끔한 /16 하나를 광고하는 네트워크는 같은 /16을 /24 256개로 광고하는 네트워크 아래로 가라앉고, 인터넷 시민으로서는 후자가 더 나쁘다고 볼 만합니다. 프리픽스 수로 정렬하는 것은 발언량으로 정렬하는 것입니다.
같은 테이블을 중복 없는 주소 공간(총 3,121,065,344개 주소)으로 줄 세우면 목록은 섞이는 정도가 아니라 해체됩니다.
| AS | 프리픽스 기준 순위 | 주소 공간 기준 순위 |
|---|---|---|
| AS16509 | 1 | 2 |
| AS9808 | 2 | 12 |
| AS8151 | 3 | 32 |
| AS12479 | 4 | 71 |
| AS7545 | 5 | 141 |
| AS39891 | 8 | 308 |
광고 수로 8위가 주소 공간으로는 308위입니다. 한편 공간에서 실제로 1위인 AS749는 프리픽스 3,133개로 그 총량의 7.17%를 쥐고 있고, AS4134는 729개로 3위에 듭니다. 큰 블록을 통째로 광고하는 네트워크, 즉 바람직한 모습이며, 프리픽스 수는 그들을 묻어 버립니다.
가는 길에 함정이 하나 있습니다. 틀리기 쉽고 조용하기 때문입니다. 이것은 합집합이어야 하며 결코 합이어서는 안 됩니다. 겹치는 프리픽스에 대해 2^(32 − 마스크 길이)를 더하면 덮고 있는 집합체를 전부 두 번 세게 되고, 테이블 전체에서 1.269배로 측정되었습니다. 순서를 바꾸기에 차고 넘칩니다. 무엇을 줄 세우거나 그리기 전에 프리픽스를 겹치지 않는 구간으로 병합해야 합니다. 우리는 처음에 합산 버전을 출하했습니다. 죽지 않았고, 총계는 그럴싸 했고, 나온 순서도 충분히 그럴듯해서 리뷰가 들여다보기 전까지 아무도 의심하지 않았습니다. 측정에서 두려워해야 할 실패 양상은 이것입니다. 스스로 티를 내는 오답이 아니라, 믿을 만한 답입니다.
수렴하는 축
다른 질문을 하십시오. “누가 가장 많이 광고하는가”가 아니라 “누가 사라지면 내 도달성이 가장 크게 깎이는가”. 탐욕적으로: 가장 많은 오리진 AS에 닿는 AS를 고르고, 그 오리진들을 풀에서 빼고, 남은 것에 대해 반복합니다. 우리가 직접 연결된 업스트림은 제외합니다. 그러지 않으면 초반 선택이 테이블에 관한 무엇이 아니라 관측 지점 자체에 지배당합니다.
| 단계 | AS | 도달한 오리진 AS의 누적 비중 |
|---|---|---|
| 1 | AS2516 | 38% |
| 2 | AS7575 | 60% |
| 3 | AS2497 | 82% |
| 4 | AS6939 | 90% |
| 5 | AS1221 | 94% |
다섯 네트워크가 이 관측 지점에서 보이는 오리진 AS의 94%에 닿습니다. 같은 테이블에서 다른 축은 53%에 닿는 데 천 개가 필요했습니다.
이것이 아키텍트가 원하는 답입니다. 이 다섯이 이 관측 지점이 올라타 있는 트랜싯 기반이고, 그중 하나를 잃는 것은 프리픽스가 가장 많은 네트워크를 잃는 것과는 다른 종류의 사건입니다.
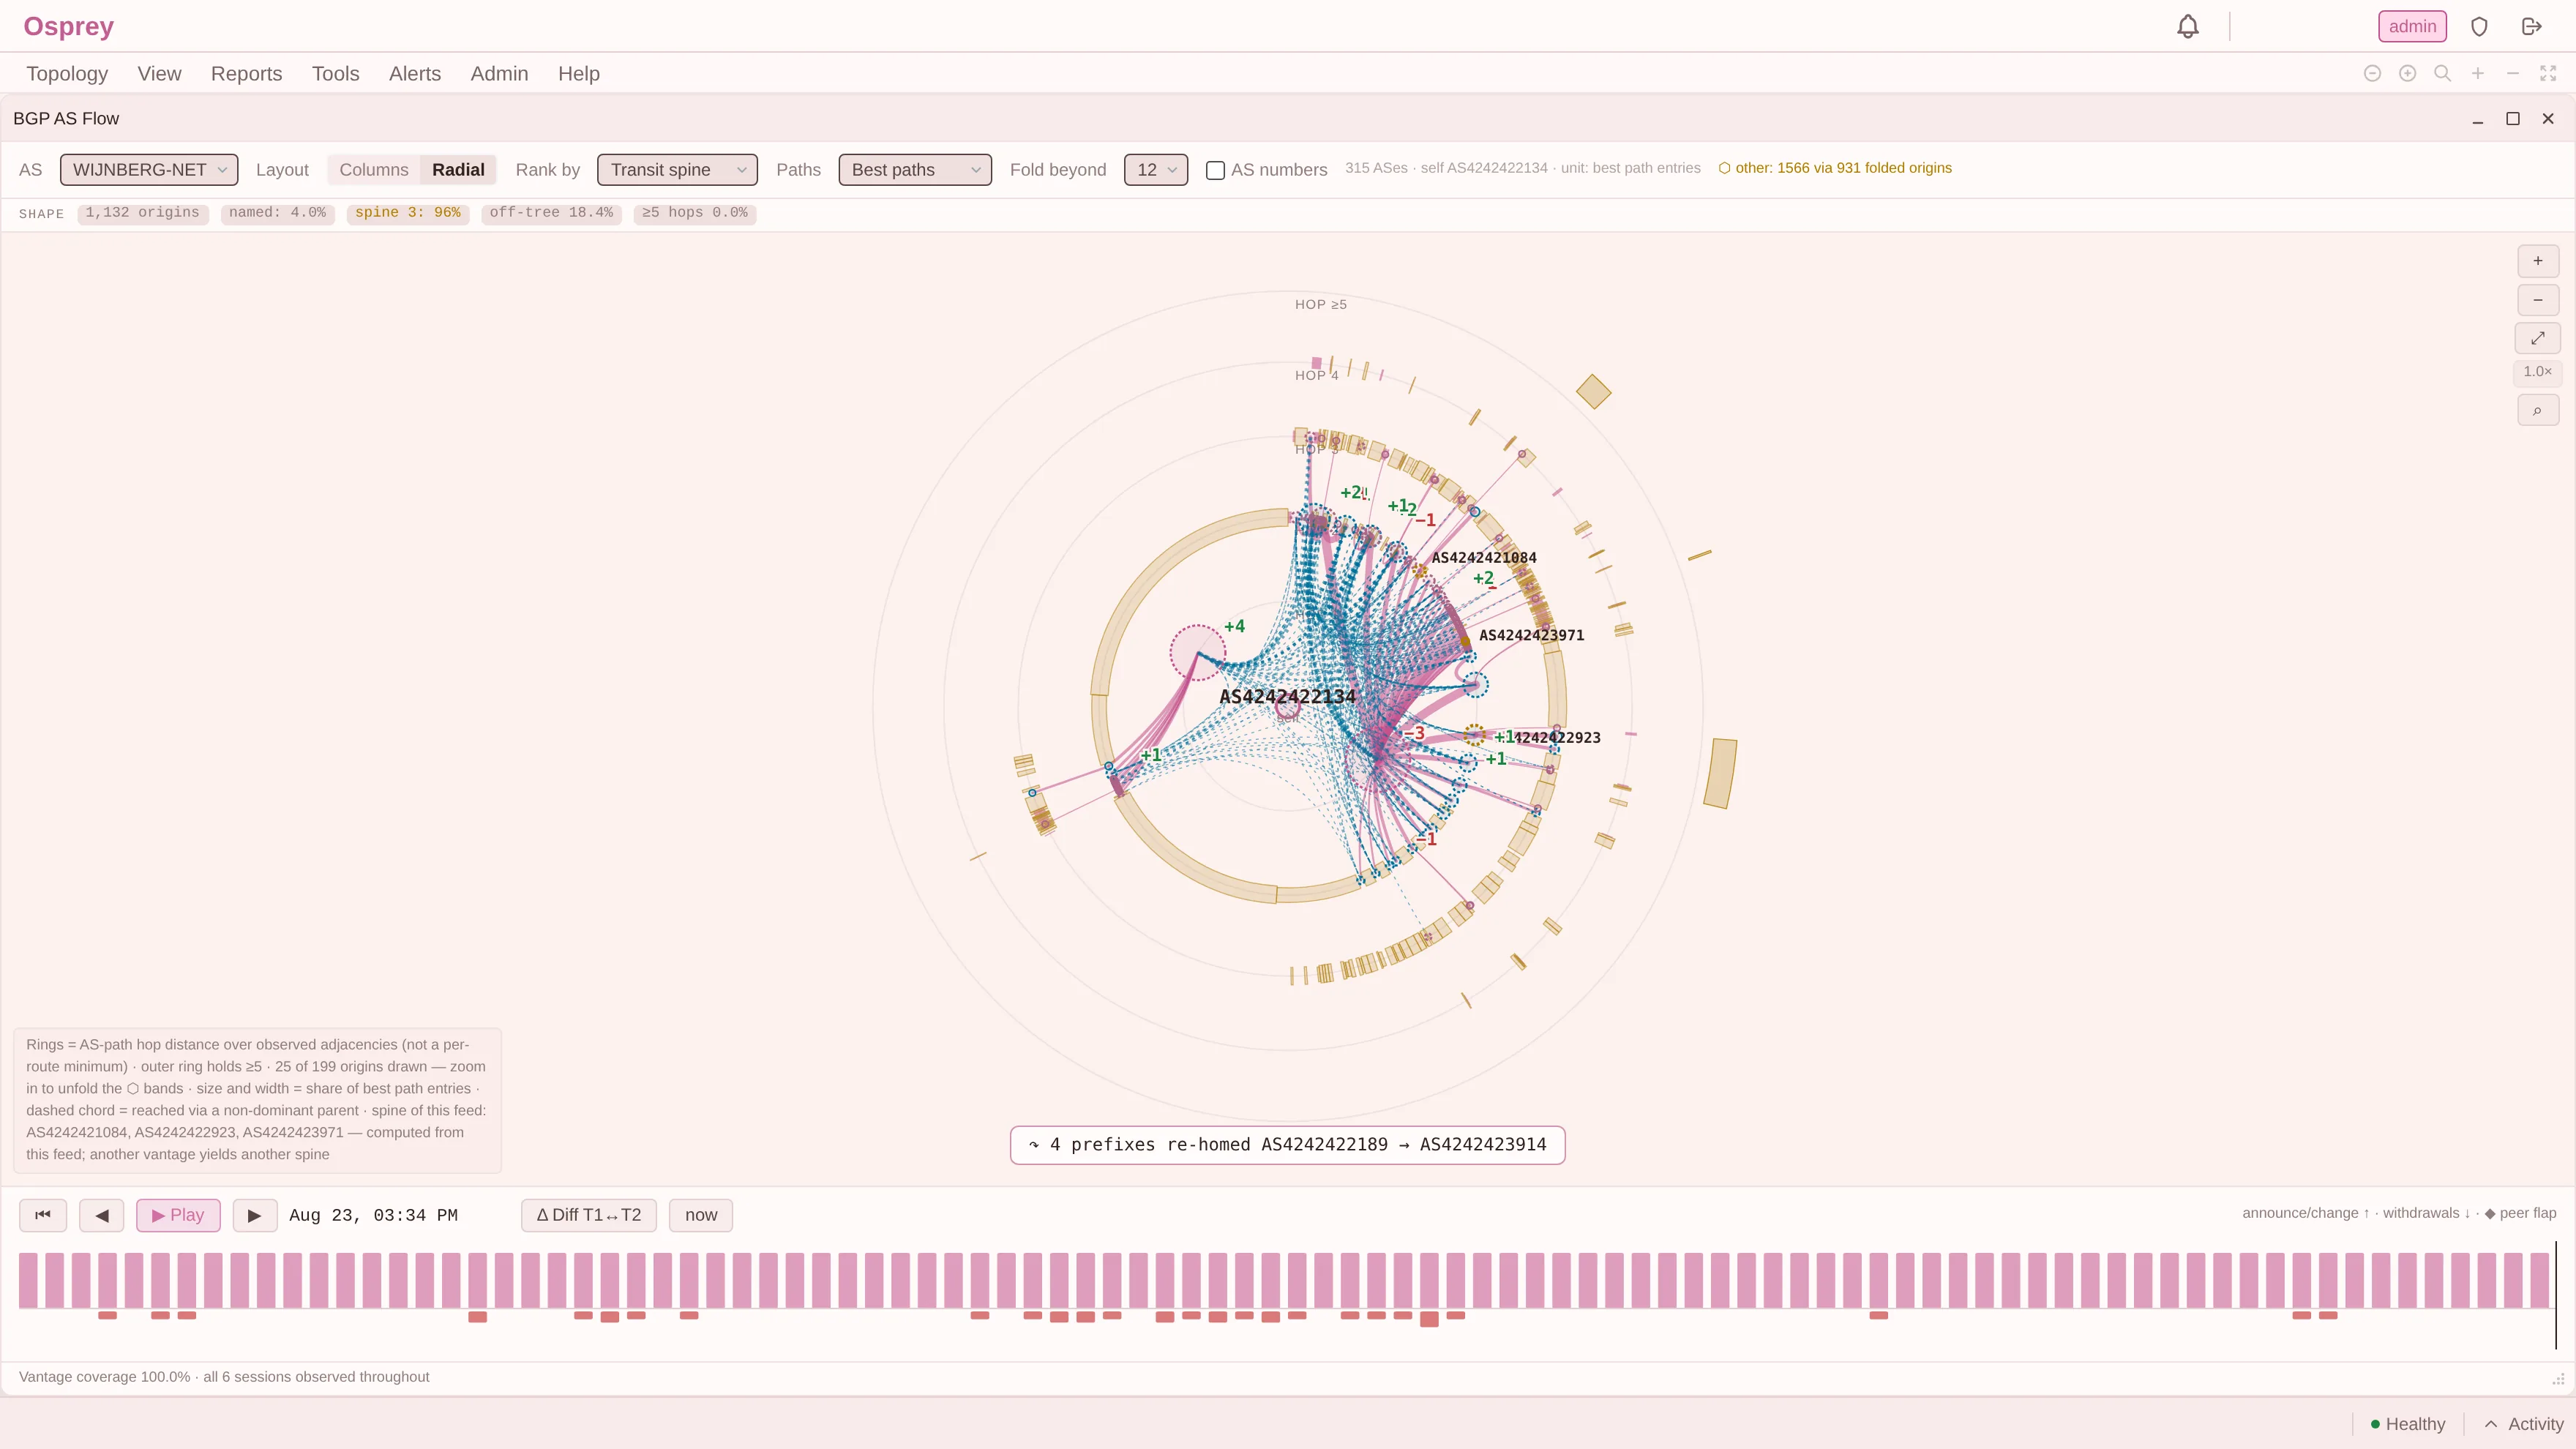
위 그림은 다르고 훨씬 작은 피드에서의 같은 컨트롤이고, 거기서 답은 다섯 개 94%가 아니라 세 개 96%입니다. 항목 수 자체는 요점이 아니고 옮겨 가지도 않습니다. 옮겨 가는 것은 이 축에는 애초에 머리가 있다는 사실, 그리고 화면의 줄들이 이야기의 대부분인지 백분의 일인지를 독자가 짐작하게 두는 대신 띠가 그 커버리지를 바로 옆에 밝혀 둔다는 사실입니다.
단서가 하나 필요합니다. 앞 글이 벌어 둔 단서입니다. 도달 범위는 지배 트리 위의 원뿔로 계산됩니다. 각 AS를 가장 무거운 선행자에 귀속시키고 그 아래 부분 트리를 합산하는 것입니다. 그것은 제가 한 편을 통째로 들여 트리가 아님을 보인 그래프의 트리 투영이고, 그 오차는 가상이 아닙니다. 가장 무거운 부모를 통해 들어오지 않는 가장자리 질량 17.5%가 바로 그것입니다. 그러니 이 수치는 비트리 위의 트리 합이며, 그래서 제품은 이를 도달성으로 제시하지 않고 그대로 이름 붙입니다. 줄 세우기에는 충분하고, 의존성 보장으로 인용하기에는 부족합니다.
이 수치가 운이 아니라 견고하다고 믿게 된 근거는 둘입니다. 같은 컬렉터의 1:10 표본, 열 개 중 한 개의 오리진을 프리픽스와 경로와 선행자까지 통째로 옮긴 것(AS 11,136개, 오리진 7,854개, 프리픽스 106,900개)이 동일한 다섯 AS를 동일한 순서로 34/62/76/86/88%에서 재현합니다. 원리도 신비롭지 않으며, 그 점이 두 축의 차이 전부입니다. 프리픽스 수는 각 네트워크가 혼자 무엇을 가졌는지 묻습니다. 프리픽스는 저마다 하나의 오리진에 속하고 공유되는 것이 없으니, 순위는 독립적인 기여들의 긴 꼬리가 됩니다. 트랜싯 도달은 각 네트워크에 무엇이 의존하는지를 묻고, 의존은 크게 겹칩니다. 한 번 고를 때마다 다음이 주장할 수 있었을 것의 대부분을 흡수 하므로, 다섯 항목이 질문을 소진하고 프리픽스 수 천 항목은 그러지 못합니다.
컨트롤을 다시 쓰게 만든 대목
여기 제가 예상하지 못한 결과가 있습니다. 같은 테이블에서 같은 한 시간 안에 뽑은 두 개의 상위 열두 목록이 공유하는 항목이 0개였습니다.
“대체로 다르다”가 아닙니다. 겹침이 아예 없습니다.
이건 동점 처리 문제가 아니고, 좋은 기본값으로 해결되는 것도 아닙니다. 이 컨트롤이 정렬 순서가 아니라는 뜻입니다. 그것은 질문 선택기이고, 두 질문은 이렇습니다.
- 누가 프리픽스를 가장 많이 광고하는가? 답: 위 분할 광고 표에 있는 네트워크들.
- 이 테이블은 무엇 위에 얹혀 있는가? 답: 완전히 다른 집합이며, 그중 어느 것도 첫 목록에 나오지 않습니다.
두 답 다 맞습니다. 어느 쪽도 “가장 큰 AS”가 아닙니다. 그 표현은 아무것도 가리키지 않으며, 그래서 하나의 순위만 내놓고 그것을 중요도라 부르는 뷰는 뒷받침할 수 없는 주장을 하는 것입니다.
그래서 Osprey의 컨트롤은 정렬 방향 하나가 아니라 명시적으로 이름 붙은 두 축이고, 옆의 임곗값은 지금 어떤 역할을 하는지 말해 줍니다. N 너머 접기는 배치 연산이고, 상위 N에 이름 붙이기는 레이블 연산이며, 같은 숫자를 두고 하는 서로 다른 두 가지 일입니다. 이를 혼동한 것이 우리 자신의 빌드에 대한 리뷰 지적 중 하나였습니다.
이것이 읽는 이에게 지우는 비용
수렴하지 않는 순위에는 운영 맥락에서 특유의 실패 양상이 있고, 자명하지 않으니 이름을 붙여 둘 만합니다.
상위 열둘이 8.3%를 덮는다면, 화면의 열두 행은 나머지 91.7%를 대표하지 못하며 화면은 그 사실을 알리지 않습니다. 거기서 추론하는 운영자는, 아무도 의도해서 고르지 않은 성질에 의해 선택된 표본에서 추론하는 셈입니다. 중요한 네트워크처럼 보입니다. 실제로는 가장 잘게 쪼개서 광고하는 네트워크들입니다.
트랜싯 도달 축은 정반대의 성질을 갖습니다. 다섯 행이 94%를 덮는다는 것은 화면이 구조의 거의 전부를 보여 주고 있고, 보이지 않는 것은 정말로 주변부라는 뜻입니다. 그것이 목록과 설명의 차이입니다.
한계
트랜싯 도달은 당신의 테이블에서 계산되므로 당신 관측 지점의 모든 성질을 물려받습니다. 그것은 인터넷 구조의 측정이 아닙니다. 당신의 피드가 그 구조를 얼마나 볼 수 있는지의 측정이며, 그 둘이 얼마나 떨어져 있는지가 다음 글의 주제입니다.
또한 업스트림이 무엇을 보내기로 했는지에 달려 있습니다. 당신에게 닿기 전에 걸러진 경로는 순위에 나타나지 않고, 어떤 계산으로도 되찾을 수 없습니다. 따라서 도달 수치는 의존성의 하한입니다. 목록에 오른 것은 전부 실재하고, 필터 뒤에는 실재하지만 오르지 못한 구조가 있을 수 있습니다.
그렇게 말하는 데는 비용이 들지 않으며, 계획에 쓸 수 있는 숫자와 당신을 곤란하게 만들 숫자의 차이가 거기에 있습니다.
요점
운영자가 어느 열두 행을 보는지 정하는 컨트롤은 표현상의 세부가 아닙니다. 이 테이블에서 그것은 둘 다 방어 가능하고 하나는 수렴하며 하나는 수렴하지 않는, 서로 겹치지 않는 두 답 사이를 가릅니다.
“가장 큰 AS”는 사실을 가리키는 말처럼 들립니다. 실제로 가리키는 것은 기본 정렬이 우연히 담아 둔 질문이고, 대부분의 도구는 그게 어느 쪽이었는지 결코 알려 주지 않습니다.
그리고 이것이 이 글이 진짜로 말하려는 설계 원칙입니다. 운영자가 무엇을 볼지 정하는 컨트롤은 자신이 답하는 질문을 드러내야 합니다. “정렬 기준: 중요도”는 편의가 아닙니다. 그것은 드롭다운 을 작성한 사람이 내린 모델 선택이며, 그런 일이 있었다는 사실조차 결코 듣지 못할 누군가를 대신해 내려진 것입니다.
다음: 그 다섯 트랜싯은 아시아태평양 네트워크이고, 그것은 인터넷에 관한 사실이 아닙니다. 당신의 백본은 인터넷의 백본이 아니다.