O LSA que você não pode retirar
Entrar num protocolo de roteamento é um aperto de mão. Sair dele termina com uma única mensagem que talvez você nunca chegue a enviar.
Michel Wijnberg
O artigo anterior tratava de entrar num protocolo de estado de enlace sem virar um caminho através dele. Este trata da outra ponta, que é mais difícil, e que eu subestimei.
Chegar é um aperto de mão. Os dois lados negociam, os dois confirmam, e se um pacote se perde você tenta de novo. Toda máquina de estados em OSPF e IS-IS existe para tornar a chegada confiável.
Sair não tem máquina de estados. Você anuncia sua partida uma vez, para um protocolo cujo propósito inteiro é lembrar o que os roteadores disseram, e então você já era e não pode corrigir nada.
A rede guarda você
Pare um gravador sem avisar ninguém e nada de dramático acontece. Esse é o problema.
Seu LSA não desaparece quando seu processo desaparece. Ele fica na base de dados de todo roteador com um número de sequência e uma idade, e vai ficar ali até a idade atingir o máximo, que em OSPF é uma hora. Por essa hora a topologia contém um roteador que não existe mais, anunciando uma adjacência para um vizinho que está silenciosamente se perguntando para onde você foi.
Uma hora de uma rede descrevendo algo falso, porque uma ferramenta de monitoramento saiu.
Então você tem de se despedir direito, e os dois protocolos têm um jeito de fazer isso que dá na mesma ideia: reoriginar aquilo que você quer remover, numa forma que signifique apague isto.
- OSPF inunda o LSA com sua idade em MaxAge, 3600 segundos, o que faz todo roteador receptor descartá-lo da sua base (RFC 2328 §13.4).
- IS-IS inunda o LSP com tempo de vida restante zero. Mesma ideia, campo diferente.
Os dois são uma mensagem só. Não há desmontagem com confirmação, nem “tem certeza”, nem laço de retentativa, porque quando isso importa o processo está saindo.
A armadilha na despedida
Aqui vai a parte fácil de errar, e que eu não teria encontrado sem rodar IS-IS autenticado.
Um LSP de purga não carrega nada. Sem alcançabilidade, sem hostname, sem capacidades. Todo o seu conteúdo é o próprio cabeçalho dizendo “tempo de vida zero”. Isso o faz parecer uma mensagem sem nada dentro a proteger.
Ele ainda assim tem de ser autenticado. A RFC 5304 exige que uma implementação usando autenticação criptográfica rejeite uma purga não autenticada, e exige que uma purga não carregue nenhum TLV além do de autenticação. As duas metades fazem sentido no instante em que você pergunta o que é uma purga não autenticada: um único pacote não assinado que apaga o estado de outro roteador, que tem a forma de um ataque em vez da forma de um desligamento.
O que significa que a única mensagem que você envia enquanto desliga, a que você não pode repetir, a que não carrega nenhum outro conteúdo, é a que mesmo assim precisa estar assinada. Erre isso e a falha é silenciosa do pior jeito: seu desligamento parece limpo do seu lado, a purga sai, roteadores que autenticam a descartam, e seu fantasma fica na base pelo tempo de vida inteiro.
Que é exatamente a forma que o código produz: o LSP de purga é construído sem carregar TLV algum, e o serializador acrescenta o TLV de autenticação quando a assinatura está configurada. Numa rede autenticada, o conteúdo inteiro daquela mensagem é a própria assinatura dela. Isso não é uma otimização. É a diferença entre sair e parecer sair.
A despedida que você não chega a enviar
Antes da mecânica, a suposição por baixo dela, porque é fácil projetar ao contrário.
Tudo acima descreve um desligamento gracioso: o processo sabe que está parando e tem tempo de enviar mais uma mensagem. Esse é o caso fácil, e não é o caso para o qual vale projetar.
O caso para o qual vale projetar é aquele em que não há mensagem nenhuma. Um sinal de kill que não espera. Um host que perde energia. Um contêiner ceifado por memória. Em cada um deles a purga nunca é enviada, e a rede fica segurando um roteador que já deixou de existir, sem notificação alguma de que algo aconteceu.
Então a purga é melhor esforço, e o projeto não pode se apoiar nela. O que precisa estar correto é o caminho que assume que ela nunca aconteceu: voltar, encontrar o próprio fantasma ainda instalado, e suplantá-lo. Se esse caminho funciona, a purga graciosa é uma otimização que encurta uma janela de indisponibilidade de uma hora para um segundo. Se não funciona, a purga graciosa é um conforto que falha exatamente quando era necessária.
Uma purga melhora a convergência. Ela não pode ser o mecanismo de correção.
É por isso que o resto deste artigo é sobre reiniciar em vez de sobre parar.
Voltar e se encontrar já lá
A outra metade do problema é o reinício, e é a que gera bugs de verdade.
Um gravador que para de forma suja, ou que é reiniciado mais rápido do que a rede esquece, volta e encontra o LSA da execução anterior ainda instalado por toda parte, portando um número de sequência. Para ser acreditada, a nova originação tem de superá-lo.
Isso soa como uma comparação de uma linha. Não é, por uma razão que vale detalhar.
Números de sequência OSPF são com sinal, de 32 bits. O valor inicial, 0x80000001, é o
número mais negativo representável, e conta-se para cima a partir dali. Então a
implementação natural de “eu vi um número de sequência anterior?” usando zero como
sentinela de sem valor está errada de um jeito que sobrevive aos testes: zero nunca é um
número de sequência OSPF válido, mas int32(0) é maior que todos os válidos. Um LSA velho
sempre perderia a comparação contra uma sentinela que deveria significar “não havia
nenhum”. O código carrega booleanos explícitos no lugar, e um comentário explicando por que
a versão óbvia é uma armadilha.
Depois vem quando fazer isso, e as duas respostas óbvias estão erradas.
O primeiro instinto é descartar o fantasma no instante em que você o vê, no meio da troca de bases, com uma inundação MaxAge. Observamos implementações Cisco reagirem mal a isso: uma limpeza MaxAge chegando enquanto a adjacência ainda estava em Loading colocava a inundação num ciclo de reinício periódico, aproximadamente a cada quarenta segundos. Nenhuma violação de especificação da parte de ninguém que eu possa apontar. Simplesmente o que aqueles roteadores faziam.
O segundo instinto, já escaldado, é esperar: registrar o número de sequência velho e reoriginar quando a adjacência chegar a Full. Isso trava. O vizinho continua anunciando o fantasma, então ele fica na nossa lista de pedidos, então a lista nunca se esvazia completamente, então Full nunca é alcançado, então a originação que teria resolvido isso nunca acontece. A recuperação passa então a esperar o temporizador de refresh, cerca de meia hora depois.
A resposta não é nenhuma das duas, e depende de uma distinção fácil de perder: o que é perigoso no meio do Loading é uma limpeza MaxAge, não uma originação. Então o gravador reorigina imediatamente, durante o Loading, como um LSA comum portando um número de sequência maior que a própria cópia e que o fantasma, e derruba de passagem a entrada velha da lista de pedidos do vizinho. Um LSA comum é seguro ali. Uma limpeza não é.
Nada disso está numa especificação. É o que a rede fez, duas vezes, de duas maneiras diferentes.
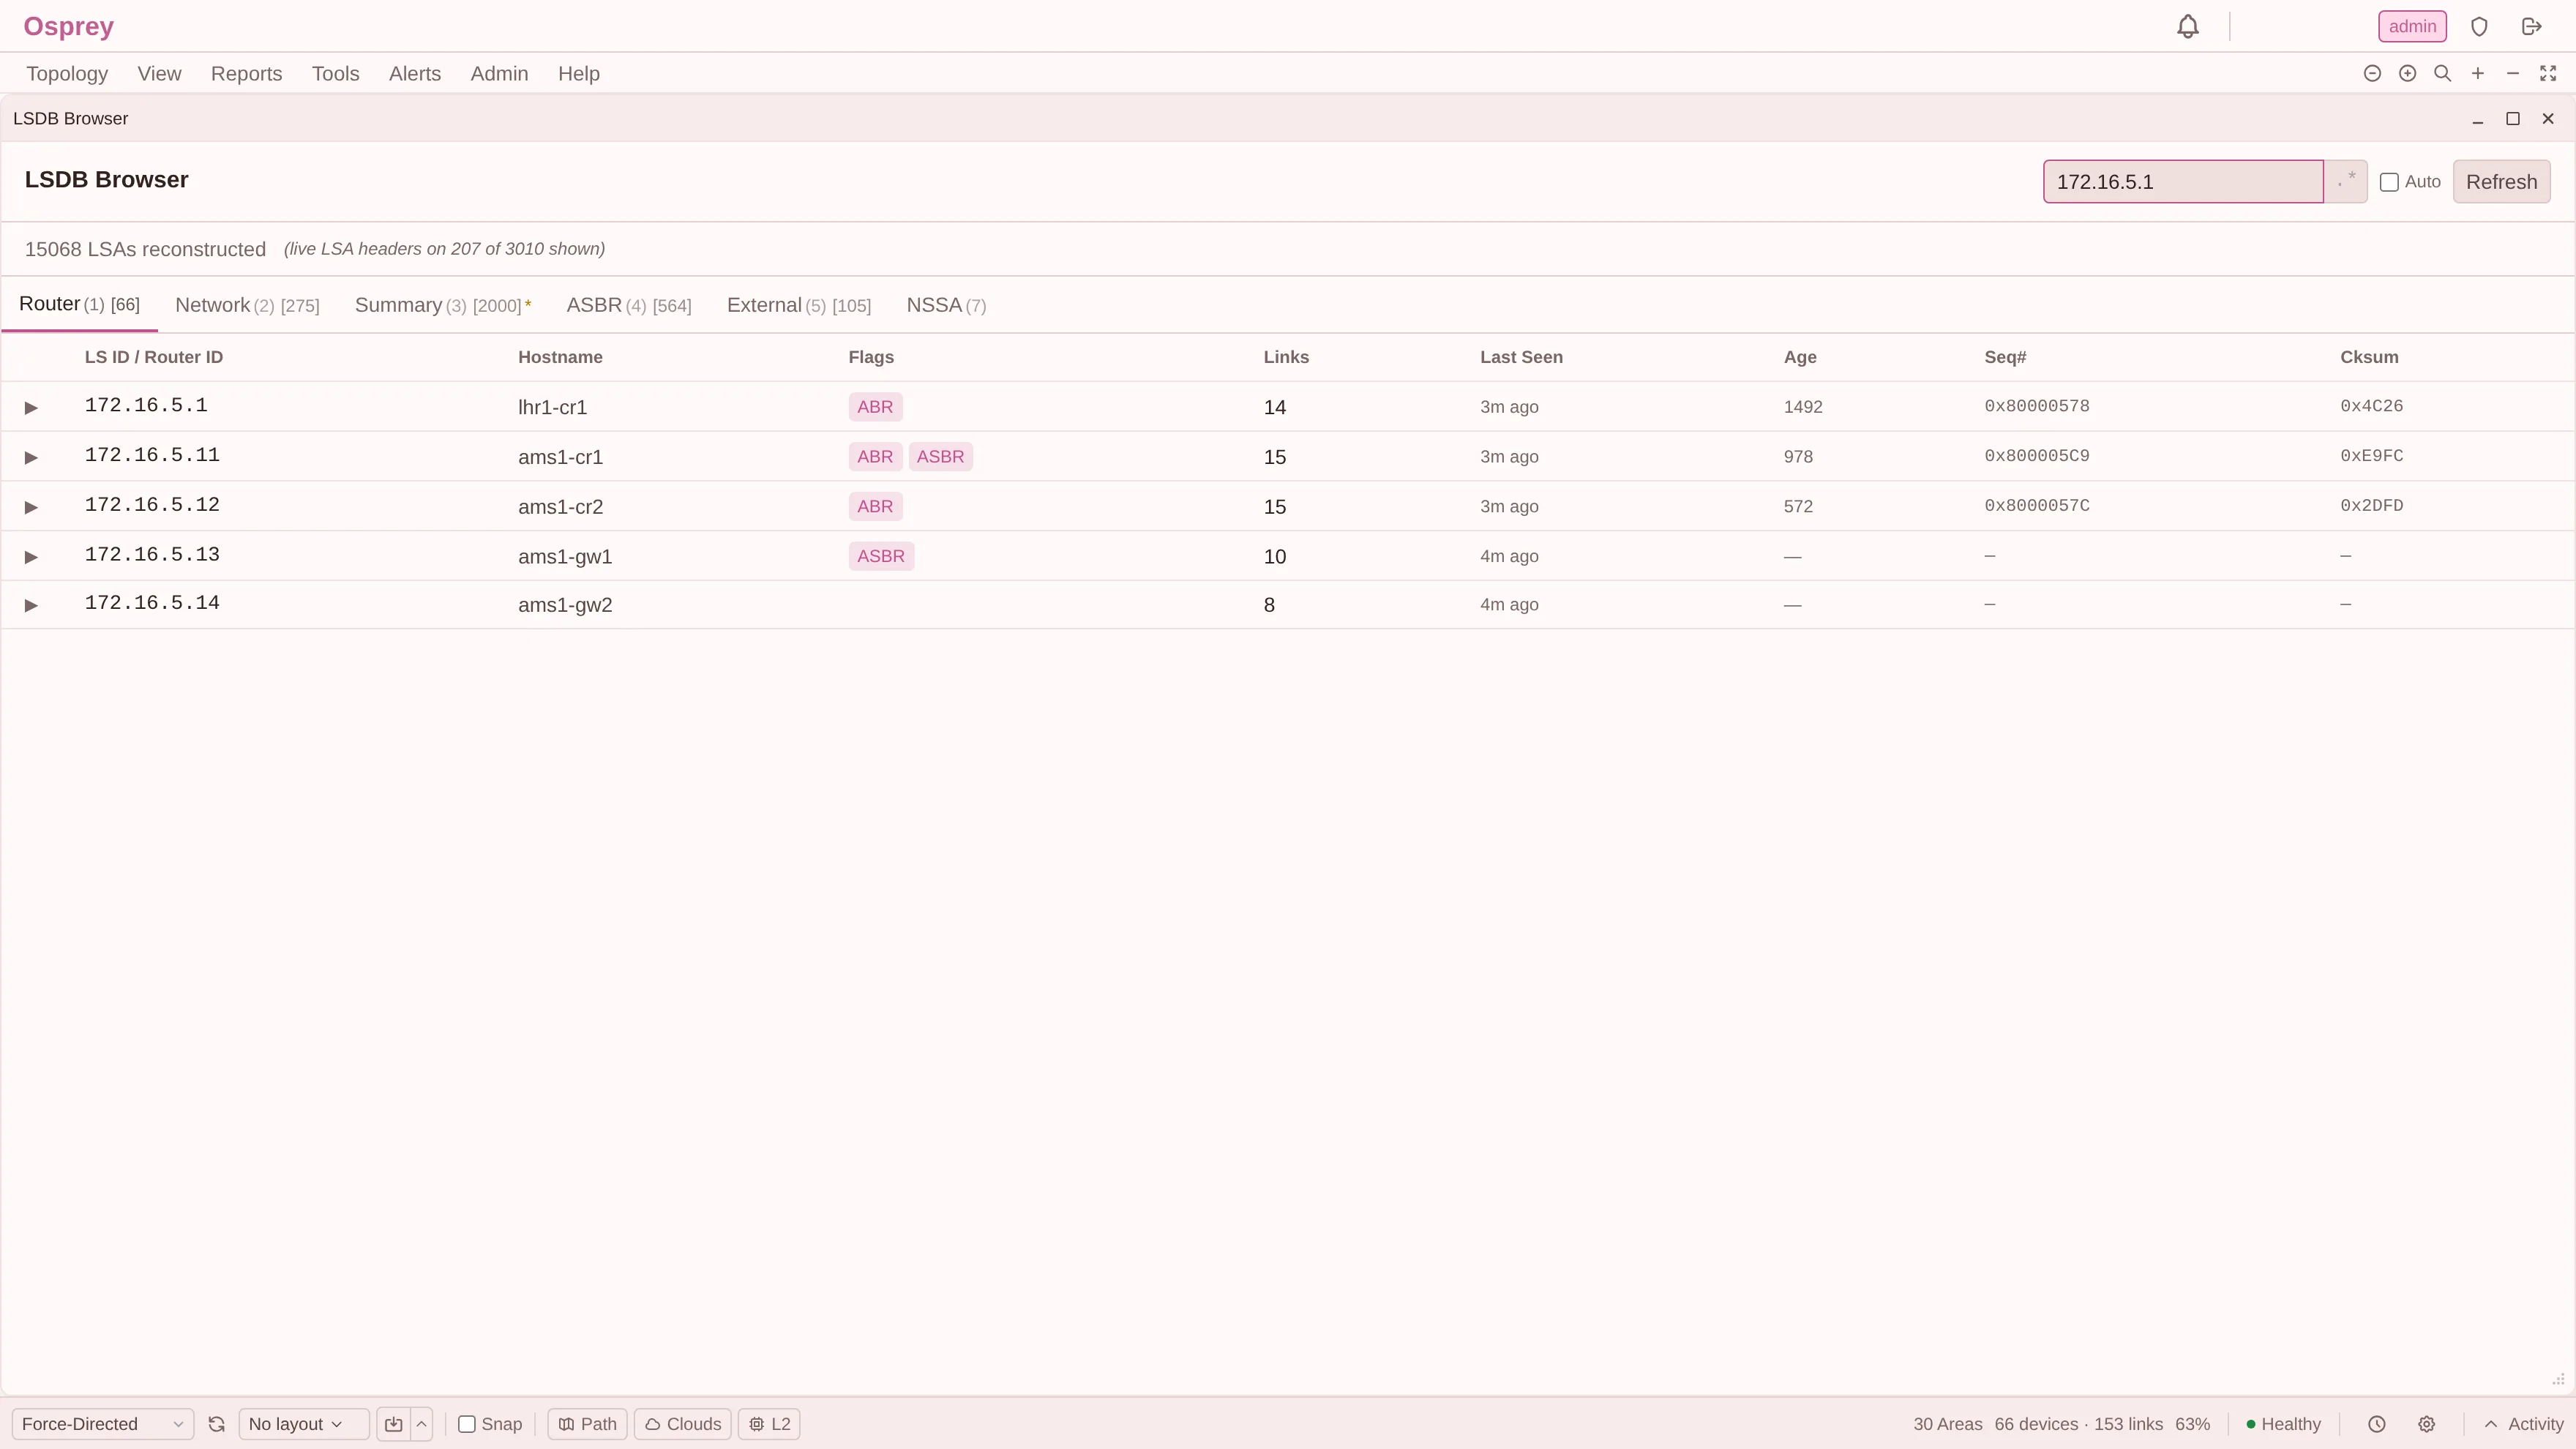
As duas colunas de que trata este artigo são exatamente as duas que tornam um LSA difícil de retirar: a idade, que tem de chegar a 3600 antes de alguém o descartar, e o número de sequência, que tem de ser batido. Onde um gravador mantém a adjacência, ambos são reais. Onde apenas um percurso SNMP reconstruiu o LSA, o navegador imprime um travessão em vez de um zero plausível.
A regra dos cinco segundos que engoliu uma adjacência
E então a falha interessante, que é o meu tipo favorito: duas regras corretas que se combinam num resultado errado.
A RFC 2328 §12.4 exige ao menos cinco segundos entre duas originações do mesmo LSA. É um limite de taxa sensato e o Osprey o aplica.
Separadamente, o LSA de substituição enviado antes de a adjacência chegar a Full carrega deliberadamente nenhum enlace. Anunciar uma adjacência que você não terminou de formar seria uma afirmação sobre uma relação de vizinhança que ainda não existe.
Agora ponha os dois no mesmo segundo. O gravador suplanta o fantasma, sem enlaces, porque não está em Full. Imediatamente depois a adjacência chega a Full e o gravador tenta originar seu LSA de verdade, o que tem o enlace dentro. Essa originação cai dentro da janela de cinco segundos e é descartada pelo limitador de taxa.
Nada dá erro. Nada tenta de novo. O gravador está agora anunciando, corretamente e em conformidade, um roteador sem enlaces, e vai continuar anunciando isso até o refresh periódico chegar.
Esse refresh são trinta minutos.
Medido no deploy de laboratório de 2026-08-05, com os dois eventos caindo no mesmo segundo: a própria adjacência do gravador apareceu como caída por meia hora, num produto cujo trabalho inteiro é dizer se adjacências estão de pé. E a parte honesta é que todo componente se comportou como projetado. O limitador de taxa obedeceu à RFC. O LSA pré-Full estava certo em não reivindicar um enlace. O bug estava no espaço entre eles, que é onde essa classe de bug sempre está.
A correção é uma retentativa única e coalescida: uma originação recusada pelo limitador de taxa não é descartada, é rearmada para quando a janela abrir.
Por que sair é a metade mais difícil
Chegar é uma negociação com retorno. Se o seu Hello está errado, a adjacência não se forma e você descobre imediatamente, ruidosamente, numa máquina de estados que não vai avançar.
Sair é uma única mensagem sem confirmação, enviada por um processo prestes a deixar de existir, que precisa estar corretamente formada e corretamente assinada na primeira tentativa, e cuja falha se parece exatamente com sucesso de onde você está.
Essa assimetria é a razão de o caminho de desligamento neste código ter mais comentários que o caminho de inicialização, e de a única mensagem sem conteúdo ser a que tem o requisito mais rígido anexado.
O ponto
Um sistema de monitoramento que não sabe sair limpo não é passivo. Ele é passivo até parar, e então é uma hora de ficção na base de topologia de outra pessoa.
A maior parte da dificuldade não está na especificação. Está na junta entre regras: um limite de taxa que é correto, um LSA pré-Full que é correto, um valor sentinela que é obviamente certo e silenciosamente errado. Nenhum deles é um mal-entendido de protocolo. São todos a mesma forma, que é a de duas coisas corretas se encontrando.
A seguir: o protocolo que não tem base de dados alguma para se entrar, e o que uma MIB não vai lhe dizer mesmo quando você pergunta educadamente. O protocolo sem base de dados.