Le LSA qu’on ne peut pas reprendre
Rejoindre un protocole de routage est une poignée de main. Le quitter se termine par un unique message qu’on n’aura peut-être jamais l’occasion d’envoyer.
Michel Wijnberg
L’article précédent portait sur le fait de rejoindre un protocole à état de liens sans en devenir un chemin. Celui-ci porte sur l’autre extrémité, plus difficile, et que j’avais sous-estimée.
Arriver est une poignée de main. Les deux côtés négocient, les deux confirment, et si un paquet se perd on réessaie. Toutes les machines à états d’OSPF et d’IS-IS existent pour rendre l’arrivée fiable.
Partir n’a pas de machine à états. Vous annoncez votre départ une fois, dans un protocole dont le seul but est de retenir ce que les routeurs ont dit, puis vous n’êtes plus là et ne pouvez plus rien corriger.
Le réseau vous garde
Arrêtez un enregistreur sans le dire à personne et il ne se passe rien de dramatique. C’est là le problème.
Votre LSA ne disparaît pas quand votre processus disparaît. Il reste dans la base de chaque routeur avec un numéro de séquence et un âge, et il y restera jusqu’à ce que l’âge atteigne le maximum, soit une heure en OSPF. Pendant cette heure, la topologie contient un routeur qui n’existe plus, annonçant une adjacence vers un voisin qui se demande en silence où vous êtes passé.
Une heure durant laquelle un réseau décrit quelque chose de faux, parce qu’un outil de supervision s’est arrêté.
Il faut donc dire au revoir correctement, et les deux protocoles ont pour cela une méthode qui revient à la même idée : réoriginer ce que vous voulez retirer, sous une forme qui signifie supprimez ceci.
- OSPF inonde le LSA avec son âge fixé à MaxAge, 3600 secondes, ce qui pousse tout routeur récepteur à le purger de sa base (RFC 2328 §13.4).
- IS-IS inonde le LSP avec une durée de vie restante nulle. Même idée, autre champ.
Les deux tiennent en un message. Il n’y a pas de démontage acquitté, pas de « êtes-vous sûr », pas de boucle de retransmission, parce qu’au moment où cela compte le processus est en train de se terminer.
Le piège dans l’adieu
Voici la partie facile à rater, et que je n’aurais pas trouvée sans faire tourner IS-IS authentifié.
Un LSP de purge ne porte rien. Pas d’accessibilité, pas de nom d’hôte, pas de capacités. Tout son contenu est son propre en-tête disant « durée de vie nulle ». Cela lui donne l’air d’un message n’ayant rien à protéger.
Il doit quand même être authentifié. Le RFC 5304 exige d’une implémentation utilisant l’authentification cryptographique qu’elle rejette une purge non authentifiée, et exige qu’une purge ne porte aucun TLV autre que celui d’authentification. Les deux moitiés prennent sens dès qu’on se demande ce qu’est une purge non authentifiée : un unique paquet non signé qui efface l’état d’un autre routeur, ce qui a la forme d’une attaque plutôt que d’un arrêt.
Ce qui signifie que l’unique message envoyé pendant l’arrêt, celui qu’on ne peut pas réémettre, celui qui ne porte aucun autre contenu, est celui qui doit malgré tout être signé. Ratez-le et l’échec est silencieux de la pire façon : votre arrêt paraît propre de votre côté, la purge part, les routeurs qui authentifient la jettent, et votre fantôme reste dans la base pendant toute la durée de vie.
C’est exactement la forme que produit le code : le LSP de purge est construit sans aucun TLV, et le sérialiseur ajoute le TLV d’authentification quand la signature est configurée. Sur un réseau authentifié, le contenu entier de ce message est sa propre signature. Ce n’est pas une optimisation. C’est la différence entre partir et sembler partir.
L’adieu qu’on n’a pas l’occasion d’envoyer
Avant la mécanique, l’hypothèse qui la sous-tend, car il est facile de concevoir à l’envers.
Tout ce qui précède décrit un arrêt propre : le processus sait qu’il s’arrête et a le temps d’envoyer un message de plus. C’est le cas facile, et ce n’est pas le cas pour lequel il faut concevoir.
Le cas pour lequel il faut concevoir est celui où il n’y a aucun message. Un signal de kill qui n’attend pas. Un hôte qui perd le courant. Un conteneur moissonné pour cause de mémoire. Dans chacun d’eux, la purge n’est jamais envoyée, et le réseau se retrouve à tenir un routeur qui a déjà cessé d’exister, sans la moindre notification que quoi que ce soit se soit produit.
La purge est donc en meilleur effort, et la conception ne peut pas s’appuyer dessus. Ce qui doit être correct, c’est le chemin qui suppose qu’elle n’a jamais eu lieu : revenir, trouver son propre fantôme encore installé, et le supplanter. Si ce chemin fonctionne, la purge propre est une optimisation qui ramène une fenêtre de panne d’une heure à une seconde. S’il ne fonctionne pas, la purge propre est un réconfort qui échoue exactement quand on en avait besoin.
Une purge améliore la convergence. Elle ne peut pas être le mécanisme de correction.
C’est pourquoi le reste de cet article parle de redémarrage plutôt que d’arrêt.
Revenir et se trouver déjà là
L’autre moitié du problème est le redémarrage, et c’est celle qui engendre de vrais bugs.
Un enregistreur qui s’arrête salement, ou qui redémarre plus vite que le réseau n’oublie, revient et trouve le LSA de l’exécution précédente encore installé partout, portant un numéro de séquence. Pour être cru, la nouvelle origination doit le battre.
Cela ressemble à une comparaison d’une ligne. Ça ne l’est pas, pour une raison qui mérite d’être détaillée.
Les numéros de séquence OSPF sont signés, sur 32 bits. La valeur initiale,
0x80000001, est le nombre le plus négatif représentable, et on compte vers le haut à
partir de là. L’implémentation naturelle de « ai-je vu un numéro de séquence précédent ? »
en utilisant zéro comme sentinelle pas de valeur est donc fausse d’une manière qui
survit aux tests : zéro n’est jamais un numéro de séquence OSPF valide, mais int32(0) est
supérieur à tous les valides. Un LSA périmé perdrait toujours la comparaison contre une
sentinelle censée signifier « il n’y en avait pas ». Le code porte des booléens explicites à
la place, et un commentaire expliquant pourquoi la version évidente est un piège.
Ensuite vient le quand, et les deux réponses évidentes sont fausses.
Le premier réflexe est de purger le fantôme dès qu’on le voit, en plein échange de bases, par une inondation MaxAge. Nous avons observé des implémentations Cisco réagir mal à cela : une purge MaxAge arrivant alors que l’adjacence était encore en Loading mettait l’inondation dans un cycle de réinitialisation périodique, environ toutes les quarante secondes. Aucune violation de spécification de la part de qui que ce soit que je puisse pointer. Simplement ce que ces routeurs faisaient.
Le deuxième réflexe, une fois cela appris, est d’attendre : noter le numéro de séquence périmé et réoriginer une fois l’adjacence en Full. Cela bloque. Le voisin annonce toujours le fantôme, il reste donc sur notre liste de demandes, la liste ne se vide donc jamais complètement, Full n’est donc jamais atteint, et l’origination qui aurait résolu la situation n’a donc jamais lieu. La reprise attend alors le temporisateur de rafraîchissement, une demi-heure plus tard.
La réponse n’est ni l’une ni l’autre, et elle tient à une distinction facile à manquer : ce qui est dangereux en plein Loading est une purge MaxAge, pas une origination. L’enregistreur réorigine donc immédiatement, pendant Loading, comme un LSA ordinaire portant un numéro de séquence supérieur à sa propre copie et au fantôme, et retire au passage l’entrée périmée de la liste de demandes du voisin. Un LSA ordinaire est sûr là. Une purge ne l’est pas.
Rien de tout cela n’est dans une spécification. C’est ce que le réseau a fait, deux fois, de deux façons différentes.
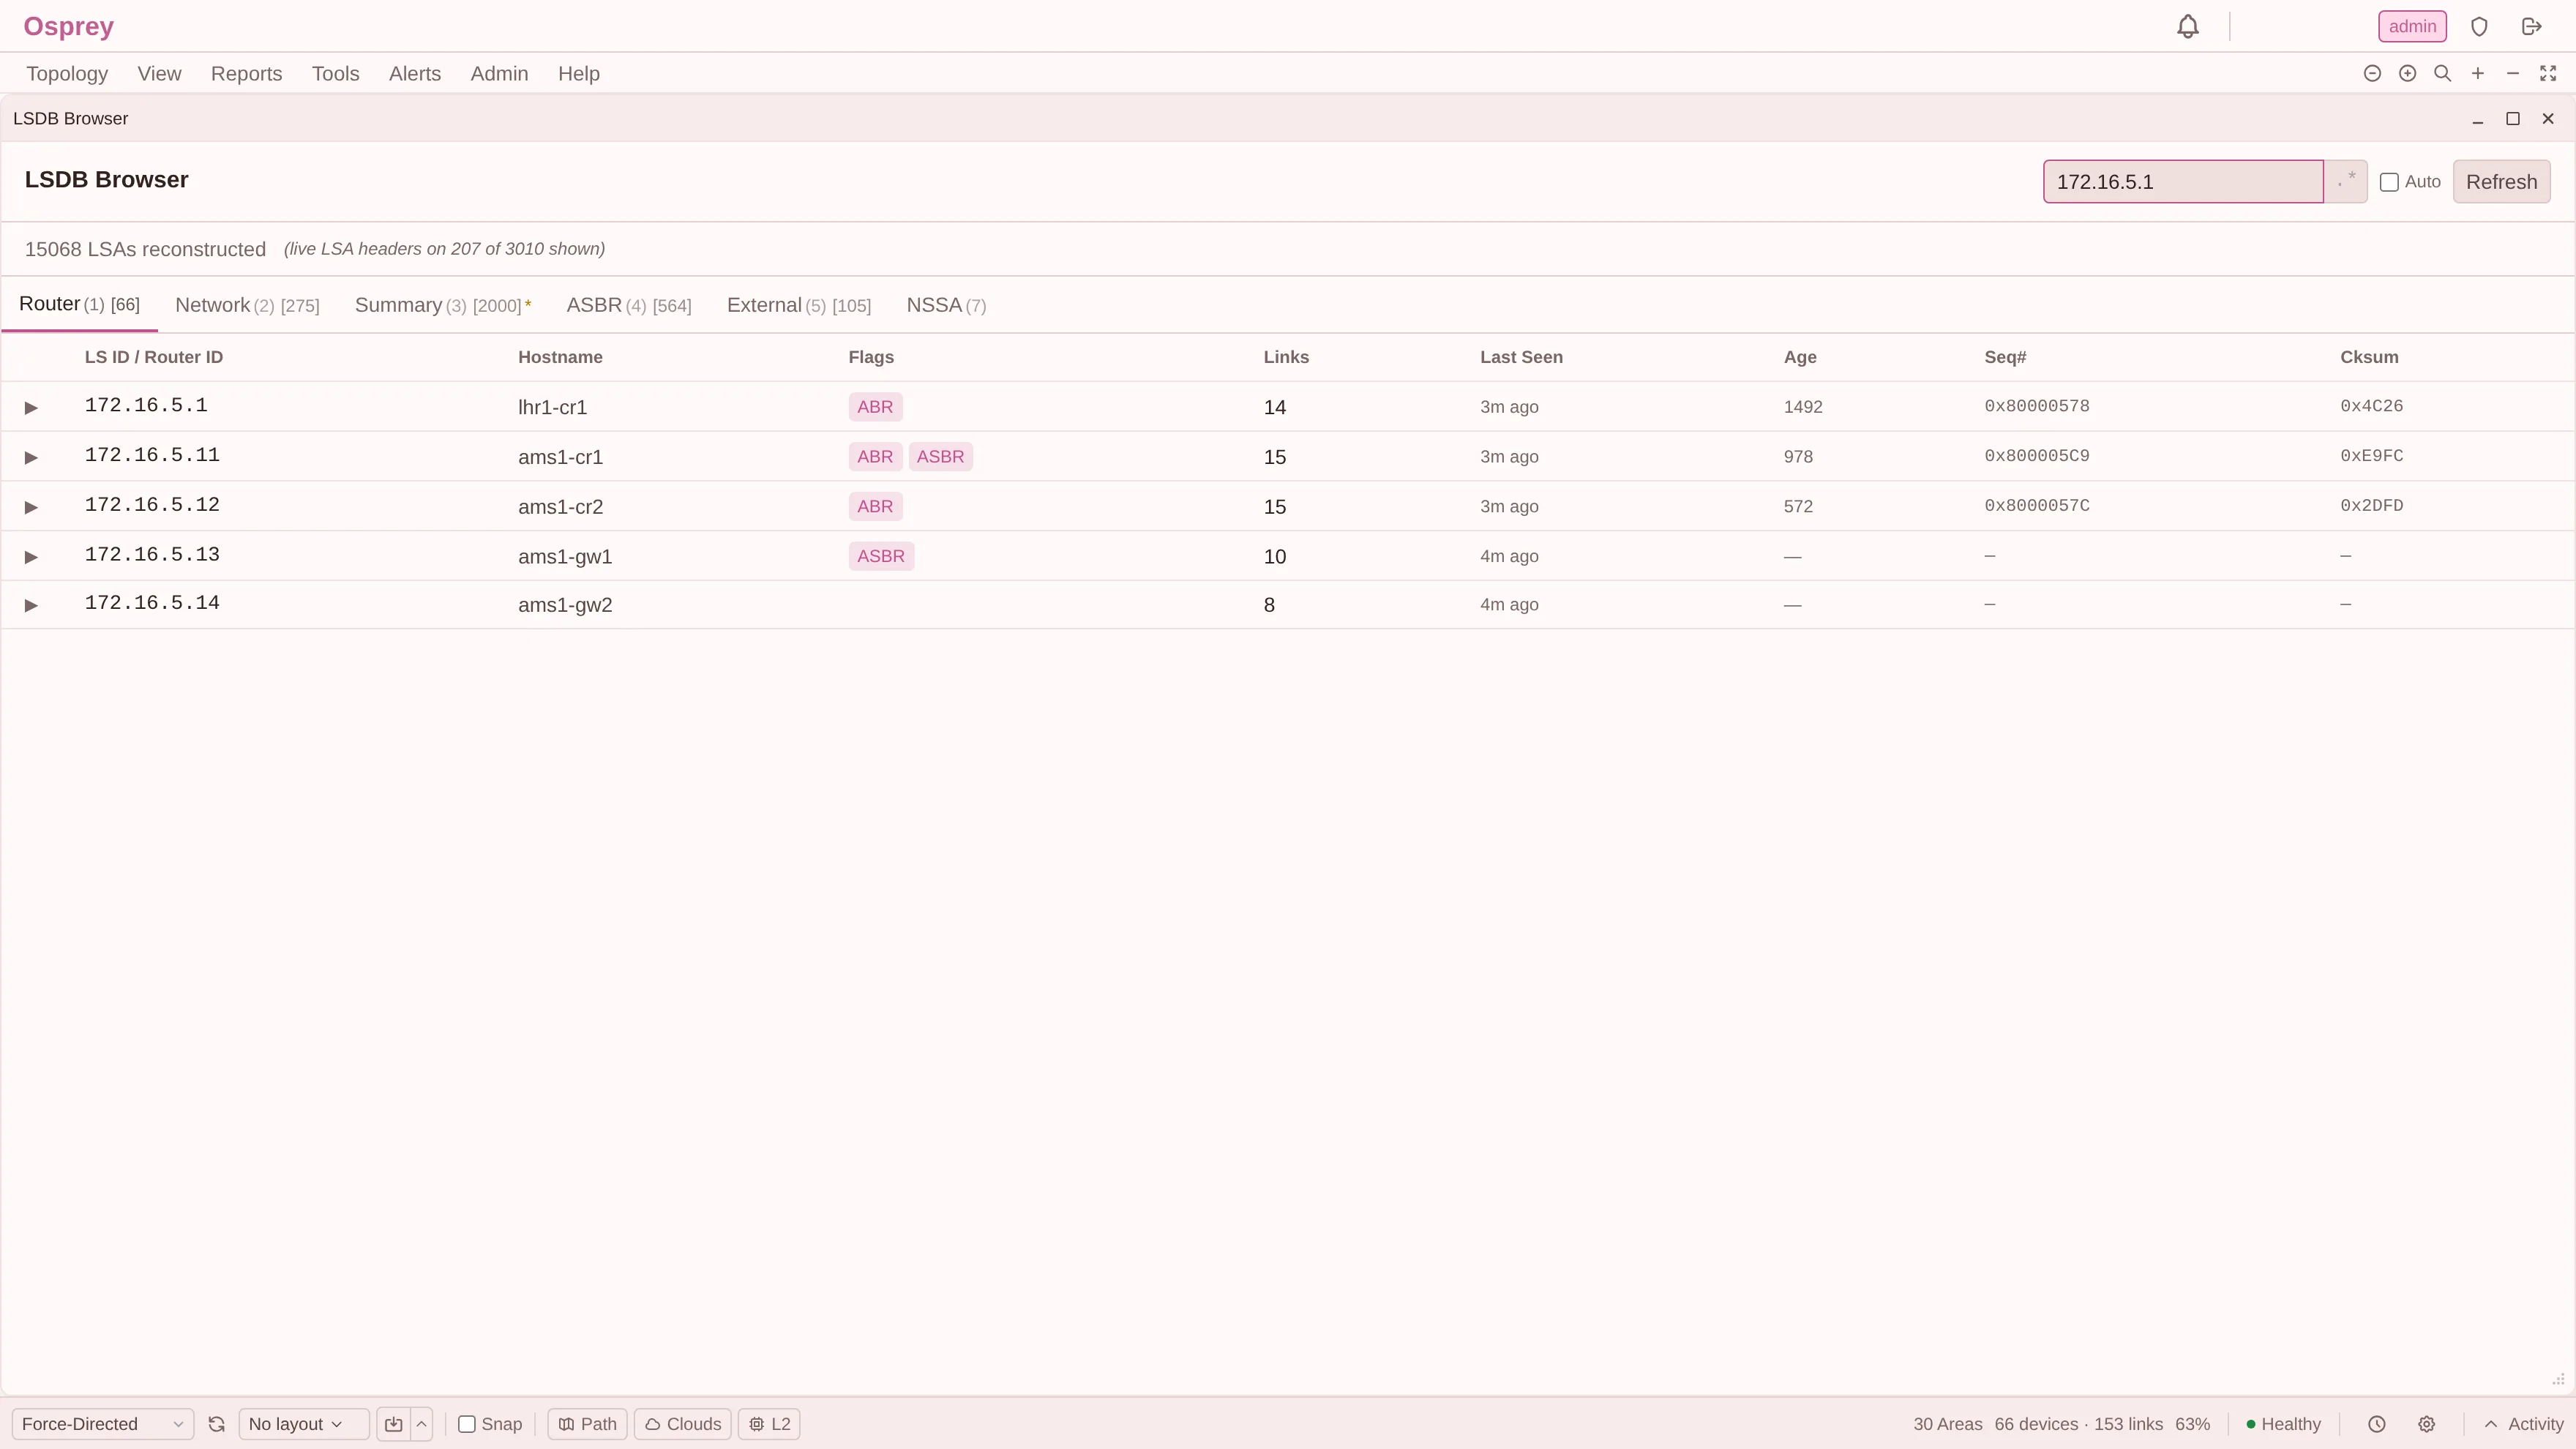
Les deux colonnes dont parle ce billet sont précisément les deux qui rendent une LSA difficile à retirer : l’âge, qui doit atteindre 3600 avant que quiconque l’abandonne, et le numéro de séquence, qu’il faut battre. Là où un enregistreur tient l’adjacence, les deux sont réels. Là où seul un parcours SNMP a reconstruit la LSA, le navigateur imprime un tiret plutôt qu’un zéro plausible.
La règle des cinq secondes qui a avalé une adjacence
Et puis la défaillance intéressante, mon genre préféré : deux règles correctes qui se combinent en un résultat faux.
Le RFC 2328 §12.4 impose au moins cinq secondes entre deux originations du même LSA. C’est une limitation de débit sensée et Osprey l’applique.
Séparément, le LSA de remplacement envoyé avant que l’adjacence n’atteigne Full ne porte délibérément aucun lien. Annoncer une adjacence qu’on n’a pas fini de former serait une affirmation sur une relation de voisinage qui n’existe pas encore.
Mettez maintenant les deux dans la même seconde. L’enregistreur supplante le fantôme, sans liens, parce qu’il n’est pas en Full. Immédiatement après, l’adjacence atteint Full et l’enregistreur tente d’originer son vrai LSA, celui qui contient le lien. Cette origination tombe dans la fenêtre de cinq secondes et le limiteur de débit la rejette.
Rien ne renvoie d’erreur. Rien ne réessaie. L’enregistreur annonce désormais, correctement et conformément, un routeur sans liens, et il continuera à annoncer cela jusqu’au rafraîchissement périodique.
Ce rafraîchissement, c’est trente minutes.
Mesuré lors du déploiement de laboratoire du 2026-08-05, les deux événements tombant dans la même seconde : la propre adjacence de l’enregistreur est apparue comme tombée pendant une demi-heure, dans un produit dont le métier entier est de dire si les adjacences sont montées. Et la part honnête, c’est que chaque composant s’est comporté comme prévu. Le limiteur de débit a obéi au RFC. Le LSA pré-Full a eu raison de ne pas revendiquer de lien. Le bug était dans l’espace entre les deux, là où cette classe de bug se trouve toujours.
Le correctif est une reprise unique et coalescée : une origination refusée par le limiteur de débit n’est pas jetée, elle est réarmée pour le moment où la fenêtre s’ouvre.
Pourquoi partir est la moitié la plus difficile
Arriver est une négociation avec retour. Si votre Hello est faux, l’adjacence ne se forme pas et vous l’apprenez immédiatement, bruyamment, dans une machine à états qui n’avancera pas.
Partir est un unique message non acquitté, envoyé par un processus sur le point de cesser d’exister, qui doit être correctement formé et correctement signé du premier coup, et dont l’échec ressemble exactement au succès depuis l’endroit où vous vous tenez.
Cette asymétrie explique pourquoi le chemin d’arrêt dans ce code comporte plus de commentaires que le chemin de démarrage, et pourquoi l’unique message sans contenu est celui auquel s’attache l’exigence la plus stricte.
L’essentiel
Un système de supervision incapable de partir proprement n’est pas passif. Il est passif jusqu’à ce qu’il s’arrête, et alors il devient une heure de fiction dans la base de topologie de quelqu’un d’autre.
L’essentiel de la difficulté n’est pas dans la spécification. Elle est dans la jointure entre des règles : une limitation de débit qui est correcte, un LSA pré-Full qui est correct, une valeur sentinelle manifestement juste et silencieusement fausse. Aucune n’est un malentendu de protocole. Elles ont toutes la même forme, celle de deux choses correctes qui se rencontrent.
Ensuite : le protocole qui n’a aucune base de données à rejoindre, et ce qu’une MIB ne vous dira pas même quand vous le demandez poliment. Le protocole sans base de données.