Das LSA, das man nicht zurücknehmen kann
Einem Routing-Protokoll beizutreten ist ein Handschlag. Eines zu verlassen endet mit einer einzigen Nachricht, die man vielleicht nie senden darf.
Michel Wijnberg
Der vorige Beitrag handelte davon, einem Link-State-Protokoll beizutreten, ohne ein Pfad hindurch zu werden. Dieser handelt vom anderen Ende, das schwerer ist und das ich unterschätzt habe.
Ankommen ist ein Handschlag. Beide Seiten verhandeln, beide bestätigen, und geht ein Paket verloren, versucht man es erneut. Jede Zustandsmaschine in OSPF und IS-IS existiert, um die Ankunft zuverlässig zu machen.
Gehen hat keine Zustandsmaschine. Man kündigt seinen Abschied einmal an, in ein Protokoll, dessen einziger Zweck es ist, sich zu merken, was Router gesagt haben, und dann ist man weg und kann nichts mehr korrigieren.
Das Netz behält dich
Halten Sie einen Recorder an, ohne es jemandem zu sagen, und nichts Dramatisches passiert. Das ist das Problem.
Ihr LSA verschwindet nicht, wenn Ihr Prozess verschwindet. Es liegt in der Datenbank jedes Routers mit einer Sequenznummer und einem Alter, und es wird dort liegen, bis das Alter sein Maximum erreicht, was in OSPF eine Stunde ist. Eine Stunde lang enthält die Topologie einen Router, der nicht mehr existiert und eine Adjazenz zu einem Nachbarn ankündigt, der sich still fragt, wo Sie hin sind.
Eine Stunde, in der ein Netz etwas Unwahres beschreibt, weil ein Monitoring-Werkzeug sich beendet hat.
Sie müssen sich also ordentlich verabschieden, und beide Protokolle haben dafür einen Weg, der auf dasselbe hinausläuft: Originieren Sie das, was Sie entfernen wollen, neu, in einer Form, die lösche dies bedeutet.
- OSPF flutet das LSA mit einem Alter von MaxAge, 3600 Sekunden, was jeden empfangenden Router dazu bringt, es aus seiner Datenbank zu spülen (RFC 2328 §13.4).
- IS-IS flutet das LSP mit verbleibender Lebensdauer null. Dieselbe Idee, anderes Feld.
Beides ist eine Nachricht. Es gibt keinen bestätigten Abbau, kein “sind Sie sicher” und keine Wiederholungsschleife, denn wenn es darauf ankommt, beendet sich der Prozess gerade.
Die Falle im Abschied
Hier der Teil, den man leicht falsch macht und den ich ohne authentifiziertes IS-IS nicht gefunden hätte.
Ein Purge-LSP trägt nichts. Keine Erreichbarkeit, keinen Hostnamen, keine Fähigkeiten. Sein gesamter Inhalt ist sein eigener Header, der “Lebensdauer null” sagt. Das lässt es aussehen wie eine Nachricht, in der nichts zu schützen ist.
Sie muss trotzdem authentifiziert werden. RFC 5304 verlangt von einer Implementierung mit kryptografischer Authentifizierung, ein unauthentifiziertes Purge abzulehnen, und verlangt, dass ein Purge außer dem Authentifizierungs-TLV keine TLVs trägt. Beide Hälften ergeben Sinn, sobald man fragt, was ein unauthentifiziertes Purge ist: ein einzelnes unsigniertes Paket, das den Zustand eines anderen Routers löscht, was die Form eines Angriffs hat und nicht die eines Herunterfahrens.
Das heißt: Die eine Nachricht, die Sie beim Herunterfahren senden, die Sie nicht wiederholen können, die überhaupt keinen anderen Inhalt trägt, ist die, die dennoch signiert sein muss. Machen Sie es falsch, und das Versagen ist auf die schlimmste Weise lautlos: Ihr Shutdown sieht von Ihrer Seite sauber aus, das Purge geht raus, authentifizierende Router verwerfen es, und Ihr Geist bleibt für die volle Lebensdauer in der Datenbank.
Genau diese Form erzeugt der Code auch: Das Purge-LSP wird ganz ohne TLVs gebaut, und der Marshaller fügt das Authentifizierungs-TLV hinzu, wenn Signieren konfiguriert ist. In einem authentifizierten Netz ist der gesamte Inhalt dieser Nachricht ihre eigene Signatur. Das ist keine Optimierung. Es ist der Unterschied zwischen Gehen und Scheinbar-Gehen.
Der Abschied, den man nicht senden darf
Vor der Mechanik die Annahme darunter, denn es ist leicht, hier verkehrt herum zu entwerfen.
Alles oben beschreibt ein sauberes Herunterfahren: Der Prozess weiß, dass er stoppt, und hat Zeit für eine letzte Nachricht. Das ist der leichte Fall, und es ist nicht der Fall, für den man entwerfen sollte.
Der Fall, für den man entwerfen sollte, ist der ohne jede Nachricht. Ein Kill-Signal, das nicht wartet. Ein Host, der Strom verliert. Ein Container, der wegen Speicher geerntet wird. In jedem davon wird das Purge nie gesendet, und das Netz bleibt mit einem Router zurück, der bereits aufgehört hat zu existieren, ohne jede Benachrichtigung, dass etwas geschehen ist.
Das Purge ist also best effort, und der Entwurf darf sich nicht darauf stützen. Was korrekt sein muss, ist der Pfad, der annimmt, es sei nie passiert: hochkommen, den eigenen Geist noch installiert vorfinden und ihn überschreiben. Funktioniert dieser Pfad, ist das saubere Purge eine Optimierung, die ein Ausfallfenster von einer Stunde auf eine Sekunde verkürzt. Funktioniert er nicht, ist das saubere Purge ein Trost, der genau dann versagt, wenn er gebraucht wurde.
Ein Purge verbessert die Konvergenz. Es kann nicht der Korrektheitsmechanismus sein.
Deshalb geht es im Rest dieses Beitrags ums Neustarten und nicht ums Anhalten.
Zurückkommen und sich schon dort vorfinden
Die andere Hälfte des Problems ist der Neustart, und der erzeugt die echten Bugs.
Ein Recorder, der unsauber stoppt oder schneller neu startet, als das Netz vergisst, kommt zurück und findet das LSA des vorigen Laufs überall installiert, mit einer Sequenznummer. Um geglaubt zu werden, muss die neue Origination sie schlagen.
Das klingt nach einem einzeiligen Vergleich. Ist es nicht, aus einem Grund, der es wert ist, ausbuchstabiert zu werden.
OSPF-Sequenznummern sind vorzeichenbehaftet, 32 Bit. Der Anfangswert 0x80000001 ist
die negativste darstellbare Zahl, und von dort wird hochgezählt. Die natürliche
Implementierung von “habe ich eine frühere Sequenznummer gesehen?” mit null als
kein-Wert-Sentinel ist also auf eine Weise falsch, die Tests übersteht: Null ist nie eine
gültige OSPF-Sequenznummer, aber int32(0) ist größer als jede gültige. Ein veraltetes
LSA würde den Vergleich gegen einen Sentinel, der “es gab keine” bedeuten sollte, immer
verlieren. Der Code trägt stattdessen explizite Booleans und einen Kommentar, warum die
naheliegende Variante eine Falle ist.
Dann die Frage, wann, und beide naheliegenden Antworten sind falsch.
Der erste Reflex ist, den Geist sofort zu spülen, wenn man ihn sieht, mitten im Datenbankaustausch, mit einer MaxAge-Flut. Wir haben beobachtet, dass Cisco-Implementierungen darauf schlecht reagieren: Eine MaxAge-Spülung, die eintraf, während die Adjazenz noch in Loading war, versetzte das Fluten in einen periodischen Reset-Zyklus, etwa alle vierzig Sekunden. Kein Spezifikationsverstoß von irgendjemandem, auf den ich zeigen könnte. Einfach das, was diese Router taten.
Der zweite Reflex, nachdem man das gelernt hat, ist zu warten: die veraltete Sequenznummer merken und neu originieren, sobald die Adjazenz Full erreicht. Das verklemmt. Der Nachbar kündigt den Geist weiterhin an, also bleibt er auf unserer Request-Liste, also leert sich die Liste nie vollständig, also wird Full nie erreicht, also findet die Origination, die es aufgelöst hätte, nie statt. Die Erholung wartet dann auf den Refresh-Timer, etwa eine halbe Stunde später.
Die Antwort ist keines von beidem, und sie hängt an einer leicht zu übersehenden Unterscheidung: Was mitten in Loading gefährlich ist, ist eine MaxAge-Spülung, nicht eine Origination. Also originiert der Recorder sofort neu, während Loading, als gewöhnliches LSA mit einer Sequenznummer höher als die eigene Kopie und der Geist, und entfernt im Vorbeigehen den veralteten Eintrag von der Request-Liste des Nachbarn. Ein gewöhnliches LSA ist dort sicher. Eine Spülung nicht.
Nichts davon steht in einer Spezifikation. Es ist das, was das Netz getan hat, zweimal, auf zwei verschiedene Arten.
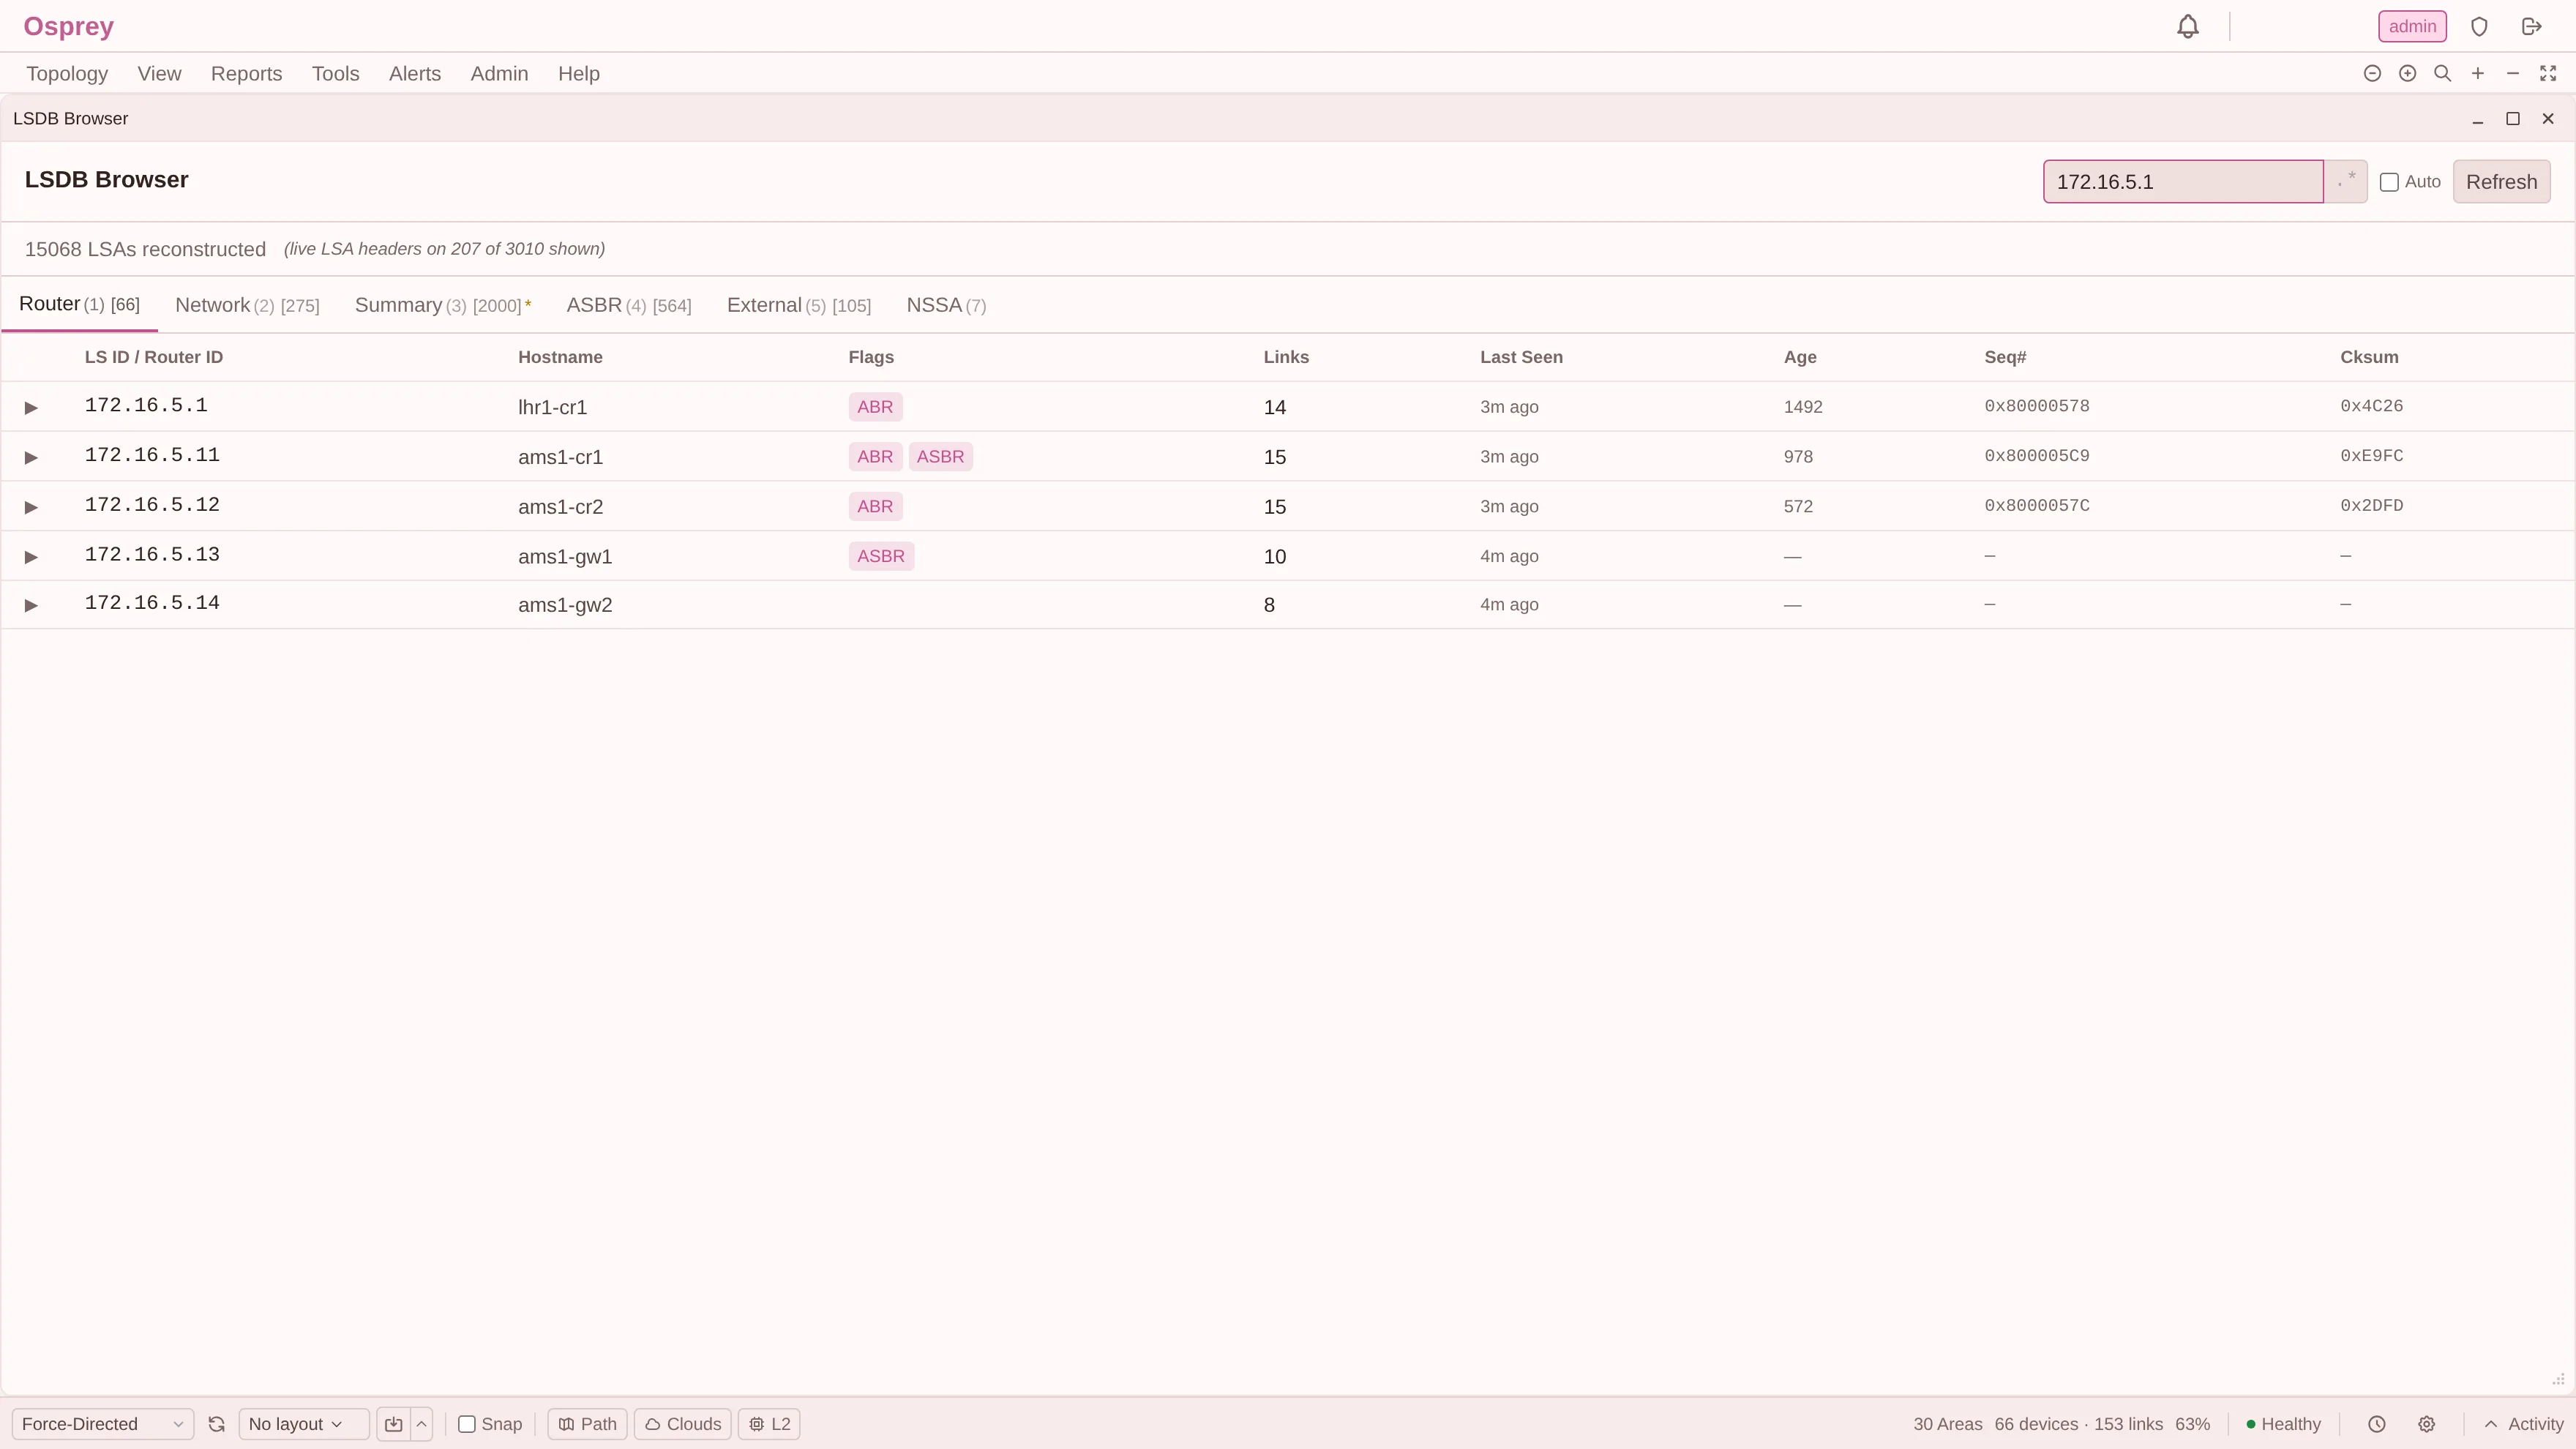
Die beiden Spalten, um die es in diesem Beitrag geht, sind genau die beiden, die eine LSA schwer zurücknehmbar machen: das Alter, das 3600 erreichen muss, bevor sie jemand verwirft, und die Sequenznummer, die geschlagen werden muss. Wo ein Rekorder die Nachbarschaft hält, sind beide echt. Wo nur ein SNMP-Walk die LSA rekonstruiert hat, druckt der Browser einen Gedankenstrich statt einer plausiblen Null.
Die Fünf-Sekunden-Regel, die eine Adjazenz verschluckte
Und dann der interessante Fehler, meine Lieblingssorte: zwei korrekte Regeln, die sich zu einem falschen Ergebnis verbinden.
RFC 2328 §12.4 verlangt mindestens fünf Sekunden zwischen zwei Originationen desselben LSA. Das ist ein sinnvolles Rate-Limit, und Osprey setzt es durch.
Separat davon trägt das Supersede-LSA, das vor Erreichen von Full gesendet wird, absichtlich keine Links. Eine Adjazenz anzukündigen, die man noch nicht fertig aufgebaut hat, wäre eine Aussage über eine Nachbarbeziehung, die es noch nicht gibt.
Nun bringen Sie beides in dieselbe Sekunde. Der Recorder überschreibt den Geist, ohne Links, weil er nicht Full ist. Unmittelbar danach erreicht die Adjazenz Full, und der Recorder versucht, sein echtes LSA zu originieren, das mit dem Link darin. Diese Origination fällt in das Fünf-Sekunden-Fenster und wird vom Rate-Limiter verworfen.
Nichts wirft einen Fehler. Nichts wiederholt. Der Recorder kündigt jetzt, korrekt und konform, einen Router ohne Links an, und wird das weiter tun, bis der periodische Refresh kommt.
Dieser Refresh sind dreißig Minuten.
Gemessen beim Labor-Deploy vom 2026-08-05, als beide Ereignisse in dieselbe Sekunde fielen: Die eigene Adjazenz des Recorders zeigte eine halbe Stunde lang als down, in einem Produkt, dessen ganze Aufgabe es ist zu sagen, ob Adjazenzen oben sind. Und der ehrliche Teil ist, dass sich jede Komponente wie entworfen verhalten hat. Der Rate-Limiter befolgte das RFC. Das Pre-Full-LSA hatte recht, keinen Link zu behaupten. Der Bug lag im Raum dazwischen, wo diese Klasse von Bug immer liegt.
Die Korrektur ist ein gebündelter One-Shot-Retry: Eine vom Rate-Limiter abgewiesene Origination wird nicht verworfen, sie wird für den Moment scharfgestellt, in dem sich das Fenster öffnet.
Warum Gehen die schwerere Hälfte ist
Ankommen ist eine Verhandlung mit Rückmeldung. Ist Ihr Hello falsch, bildet sich die Adjazenz nicht, und Sie erfahren es sofort, laut, in einer Zustandsmaschine, die nicht weitergeht.
Gehen ist eine einzelne unbestätigte Nachricht, gesendet von einem Prozess, der gleich aufhört zu existieren, die beim ersten Versuch korrekt geformt und korrekt signiert sein muss, und deren Scheitern von dort, wo Sie stehen, genau wie Erfolg aussieht.
Diese Asymmetrie ist der Grund, warum der Shutdown-Pfad in diesem Code mehr Kommentare hat als der Startup-Pfad, und warum die eine Nachricht ohne Inhalt die mit der strengsten Anforderung ist.
Der Punkt
Ein Monitoring-System, das nicht sauber gehen kann, ist nicht passiv. Es ist passiv, bis es stoppt, und dann ist es eine Stunde Fiktion in der Topologiedatenbank eines anderen.
Der meiste Aufwand steckt nicht in der Spezifikation. Er steckt in der Fuge zwischen Regeln: ein Rate-Limit, das korrekt ist, ein Pre-Full-LSA, das korrekt ist, ein Sentinel-Wert, der offensichtlich richtig und still falsch ist. Keines davon ist ein Protokollmissverständnis. Sie haben alle dieselbe Form, nämlich zwei korrekte Dinge, die sich treffen.
Als Nächstes: das Protokoll, das gar keine Datenbank zum Beitreten hat, und was eine MIB Ihnen nicht sagt, selbst wenn Sie höflich fragen. Das Protokoll ohne Datenbank.