El LSA que no puedes retirar
Unirse a un protocolo de enrutamiento es un apretón de manos. Abandonarlo termina con un único mensaje que quizá nunca llegues a enviar.
Michel Wijnberg
El artículo anterior trataba de unirse a un protocolo de estado de enlace sin convertirse en un camino a través de él. Este trata del otro extremo, que es más difícil, y que yo subestimé.
Llegar es un apretón de manos. Ambos lados negocian, ambos confirman, y si se pierde un paquete se reintenta. Toda máquina de estados de OSPF y de IS-IS existe para que la llegada sea fiable.
Marcharse no tiene máquina de estados. Anuncias tu partida una vez, hacia un protocolo cuyo único propósito es recordar lo que dijeron los routers, y después ya no estás y no puedes corregir nada.
La red te conserva
Pare un grabador sin decírselo a nadie y no pasa nada dramático. Ese es el problema.
Su LSA no desaparece cuando desaparece su proceso. Sigue en la base de datos de cada router con un número de secuencia y una edad, y seguirá ahí hasta que la edad alcance el máximo, que en OSPF es una hora. Durante esa hora la topología contiene un router que ya no existe, anunciando una adyacencia hacia un vecino que se pregunta en silencio dónde se metió usted.
Una hora de una red describiendo algo falso, porque una herramienta de monitorización terminó.
Así que hay que despedirse como es debido, y ambos protocolos tienen una manera de hacerlo que se reduce a la misma idea: reoriginar aquello que quiere eliminar, en una forma que signifique borra esto.
- OSPF inunda el LSA con su edad puesta a MaxAge, 3600 segundos, lo que hace que todo router receptor lo elimine de su base de datos (RFC 2328 §13.4).
- IS-IS inunda el LSP con tiempo de vida restante cero. La misma idea, otro campo.
Los dos son un solo mensaje. No hay desmontaje reconocido, ni “¿está seguro?”, ni bucle de reintento, porque para cuando importa el proceso está saliendo.
La trampa de la despedida
Aquí va la parte que es fácil equivocar, y que no habría encontrado sin ejecutar IS-IS autenticado.
Un LSP de purga no lleva nada. Ni alcanzabilidad, ni nombre de host, ni capacidades. Todo su contenido es su propia cabecera diciendo “tiempo de vida cero”. Eso hace que parezca un mensaje sin nada dentro que proteger.
Aun así tiene que autenticarse. El RFC 5304 exige que una implementación que use autenticación criptográfica rechace una purga no autenticada, y exige que una purga no lleve más TLV que el de autenticación. Las dos mitades cobran sentido en cuanto uno se pregunta qué es una purga no autenticada: un único paquete sin firmar que borra el estado de otro router, que tiene la forma de un ataque y no la de un apagado.
Lo que significa que el único mensaje que envía mientras se apaga, el que no puede reintentar, el que no lleva ningún otro contenido, es el que debe ir firmado igualmente. Equivóquese y el fallo es silencioso de la peor manera: su apagado parece limpio desde su lado, la purga sale, los routers que autentican la descartan, y su fantasma se queda en la base de datos el tiempo de vida completo.
Que es exactamente la forma que produce el código: el LSP de purga se construye sin llevar ningún TLV, y el serializador añade el TLV de autenticación cuando la firma está configurada. En una red autenticada, todo el contenido de ese mensaje es su propia firma. Eso no es una optimización. Es la diferencia entre marcharse y parecer que se marcha.
La despedida que no llegas a enviar
Antes de la mecánica, la suposición que hay debajo, porque es fácil diseñar del revés.
Todo lo anterior describe un apagado ordenado: el proceso sabe que está parando y tiene tiempo de enviar un mensaje más. Ese es el caso fácil, y no es el caso para el que hay que diseñar.
El caso para el que hay que diseñar es aquel en el que no hay mensaje alguno. Una señal de kill que no espera. Un host que pierde la alimentación. Un contenedor segado por memoria. En todos ellos la purga no se envía nunca, y la red se queda sosteniendo un router que ya ha dejado de existir, sin ninguna notificación de que haya pasado nada.
Así que la purga es de mejor esfuerzo, y el diseño no puede apoyarse en ella. Lo que tiene que ser correcto es la ruta que asume que nunca ocurrió: volver a levantarse, encontrar el propio fantasma todavía instalado, y sustituirlo. Si esa ruta funciona, la purga ordenada es una optimización que acorta una ventana de caída de una hora a un segundo. Si no funciona, la purga ordenada es un consuelo que falla justo cuando hacía falta.
Una purga mejora la convergencia. No puede ser el mecanismo de corrección.
Por eso el resto de este artículo va sobre reiniciar y no sobre parar.
Volver y encontrarse ya allí
La otra mitad del problema es el reinicio, y es la que genera bugs reales.
Un grabador que para sucio, o que se reinicia más rápido de lo que la red olvida, vuelve y se encuentra el LSA de la ejecución anterior todavía instalado en todas partes, con un número de secuencia. Para ser creído, la nueva originación tiene que superarlo.
Eso suena a comparación de una línea. No lo es, por una razón que merece deletrearse.
Los números de secuencia de OSPF son con signo, de 32 bits. El valor inicial,
0x80000001, es el número más negativo representable, y se cuenta hacia arriba desde ahí.
Así que la implementación natural de “¿he visto un número de secuencia anterior?” usando
cero como centinela de sin valor está mal de una forma que sobrevive a las pruebas: cero
nunca es un número de secuencia OSPF válido, pero int32(0) es mayor que cualquiera
válido. Un LSA obsoleto perdería siempre la comparación contra un centinela que debía
significar “no había ninguno”. El código lleva booleanos explícitos en su lugar, y un
comentario que explica por qué la versión obvia es una trampa.
Luego está cuándo hacerlo, y las dos respuestas obvias están mal.
El primer instinto es eliminar el fantasma en cuanto se ve, en pleno intercambio de bases de datos, con una inundación MaxAge. Observamos que implementaciones de Cisco reaccionaban mal a eso: una eliminación MaxAge que llegaba mientras la adyacencia seguía en Loading metía la inundación en un ciclo de reinicio periódico, más o menos cada cuarenta segundos. No es una violación de la especificación por parte de nadie que yo pueda señalar. Simplemente es lo que aquellos routers hacían.
El segundo instinto, ya escarmentado, es esperar: anotar el número de secuencia obsoleto y reoriginar cuando la adyacencia llegue a Full. Eso se bloquea. El vecino sigue anunciando el fantasma, así que este permanece en nuestra lista de peticiones, así que la lista nunca se vacía del todo, así que Full nunca se alcanza, así que la originación que lo habría resuelto nunca ocurre. La recuperación queda entonces esperando al temporizador de refresco, media hora después.
La respuesta no es ninguna de las dos, y gira sobre una distinción fácil de pasar por alto: lo peligroso en pleno Loading es una eliminación MaxAge, no una originación. Así que el grabador reorigina inmediatamente, durante Loading, como un LSA ordinario que lleva un número de secuencia mayor que su propia copia y que el fantasma, y de paso quita la entrada obsoleta de la lista de peticiones del vecino. Un LSA ordinario es seguro ahí. Una eliminación no.
Nada de esto está en una especificación. Es lo que la red hizo, dos veces, de dos maneras distintas.
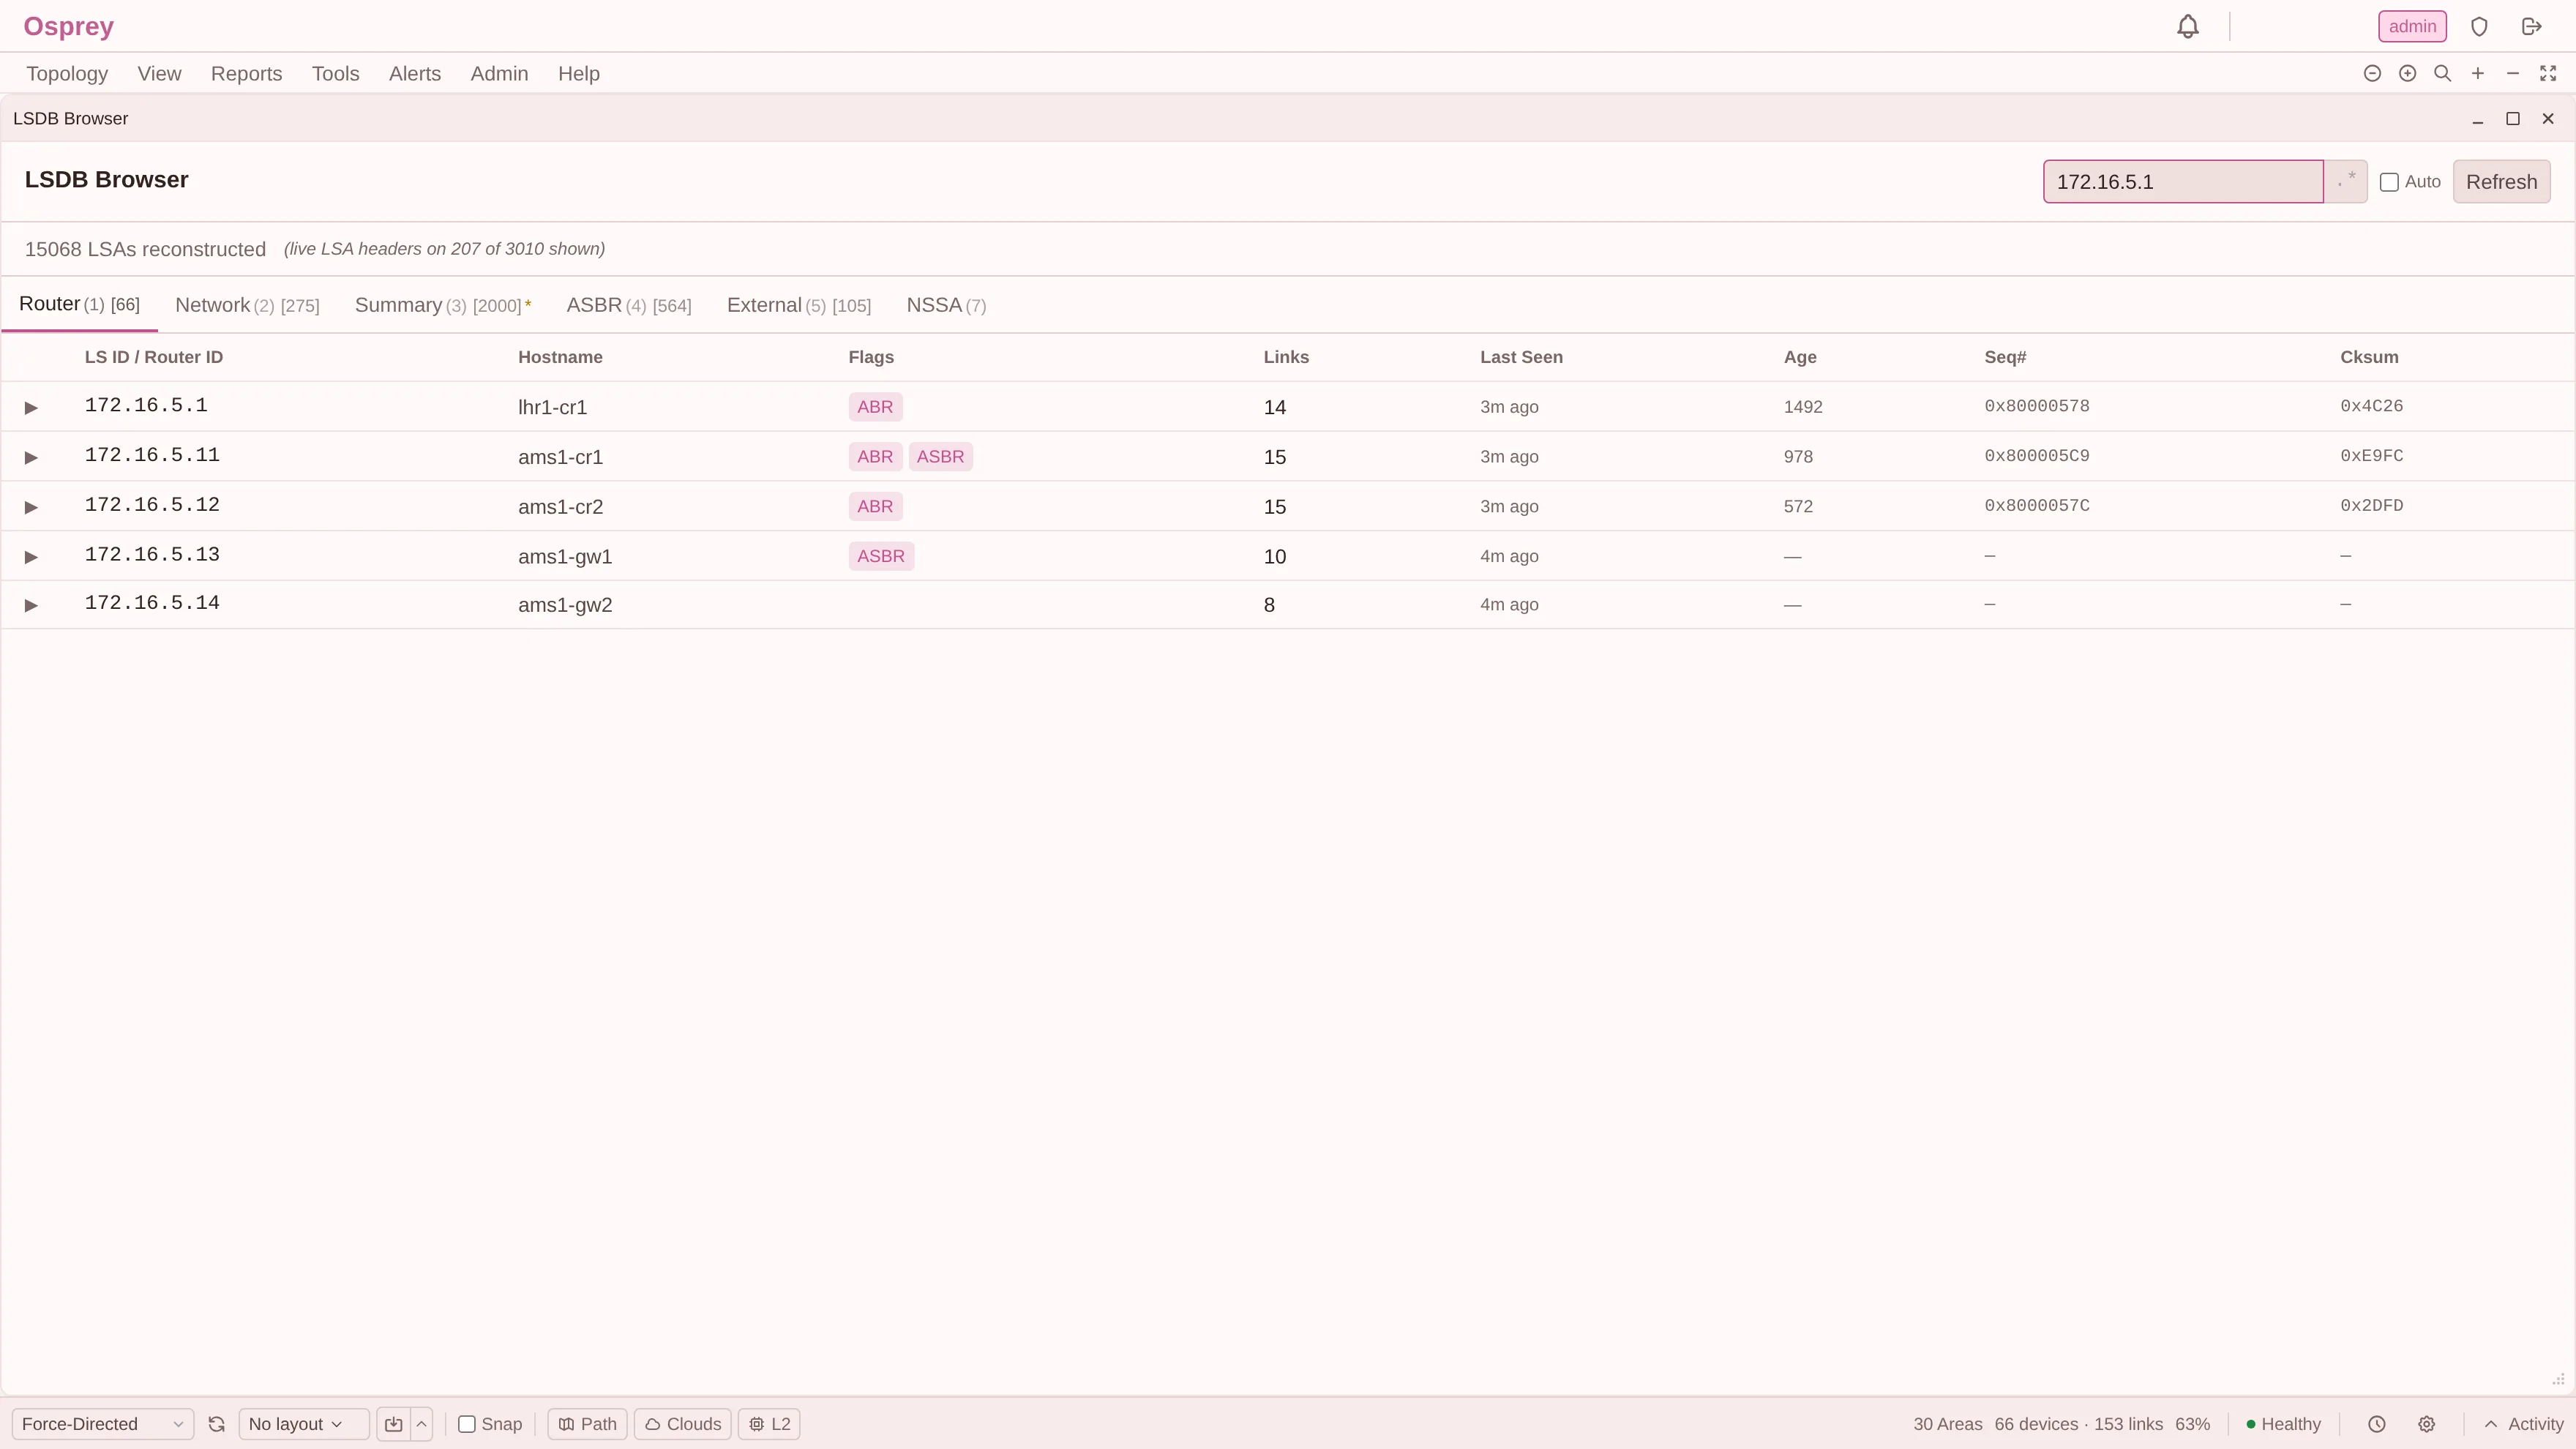
Las dos columnas de las que trata este artículo son justo las dos que hacen difícil retirar un LSA: la edad, que tiene que llegar a 3600 antes de que alguien lo descarte, y el número de secuencia, que hay que superar. Donde un grabador mantiene la adyacencia, ambas son reales. Donde solo un recorrido SNMP reconstruyó el LSA, el navegador imprime una raya en lugar de un cero plausible.
La regla de los cinco segundos que se tragó una adyacencia
Y luego el fallo interesante, que es mi tipo favorito: dos reglas correctas que se combinan en un resultado equivocado.
El RFC 2328 §12.4 exige al menos cinco segundos entre dos originaciones del mismo LSA. Es un límite de tasa sensato y Osprey lo aplica.
Por separado, el LSA de sustitución que se envía antes de que la adyacencia llegue a Full lleva deliberadamente cero enlaces. Anunciar una adyacencia que aún no ha terminado de formar sería afirmar una relación de vecindad que todavía no existe.
Ahora póngalos en el mismo segundo. El grabador sustituye al fantasma, sin enlaces, porque no está en Full. Inmediatamente después la adyacencia llega a Full y el grabador intenta originar su LSA real, el que lleva el enlace. Esa originación cae dentro de la ventana de cinco segundos y el limitador de tasa la descarta.
Nada da error. Nada reintenta. El grabador está ahora anunciando, correcta y conformemente, un router sin enlaces, y seguirá anunciando eso hasta que llegue el refresco periódico.
Ese refresco es de treinta minutos.
Medido en el despliegue de laboratorio del 2026-08-05, con los dos eventos cayendo en el mismo segundo: la propia adyacencia del grabador apareció como caída durante media hora, en un producto cuyo trabajo entero es decir si las adyacencias están arriba. Y la parte honesta es que cada componente se comportó según su diseño. El limitador de tasa obedeció al RFC. El LSA previo a Full hizo bien en no afirmar un enlace. El bug estaba en el espacio entre ambos, que es donde siempre está esta clase de bug.
El arreglo es un reintento único y agrupado: una originación rechazada por el limitador de tasa no se descarta, se rearma para cuando la ventana se abra.
Por qué marcharse es la mitad más difícil
Llegar es una negociación con retroalimentación. Si su Hello está mal, la adyacencia no se forma y usted se entera de inmediato, ruidosamente, en una máquina de estados que no va a avanzar.
Marcharse es un único mensaje sin acuse, enviado por un proceso que está a punto de dejar de existir, que debe estar bien formado y bien firmado al primer intento, y cuyo fracaso se parece exactamente al éxito desde donde usted está.
Esa asimetría es la razón de que la ruta de apagado en este código tenga más comentarios que la de arranque, y de que el único mensaje sin contenido sea el que lleva el requisito más estricto.
La idea
Un sistema de monitorización que no sabe marcharse limpiamente no es pasivo. Es pasivo hasta que para, y luego es una hora de ficción en la base de datos de topología de otro.
La mayor parte de la dificultad no está en la especificación. Está en la unión entre reglas: un límite de tasa que es correcto, un LSA previo a Full que es correcto, un valor centinela que es obviamente acertado y silenciosamente erróneo. Ninguno es un malentendido de protocolo. Todos tienen la misma forma, que es la de dos cosas correctas encontrándose.
Siguiente: el protocolo que no tiene ninguna base de datos a la que unirse, y lo que una MIB no le dirá ni aunque se lo pida educadamente. El protocolo sin base de datos.